ARTICLE · 1233166
AI网络哪家强?800G 刚坐稳,1.6T 就来抢班?
上一篇聊全闪,存储从仓库变引擎。这一篇顺着连线往里走,到网络。过去买交换机,逻辑是园区网稳、数据中心网别丢包,网络是算力背后的配角,预算占比小、存在感低。这个逻辑在 AI 集群一来就破了。
最容易被一句话带偏的说法是「网络不就是连设备的线,卡够快就行」。真把万卡训练的账摆开看,GPU 算得越快越被网络卡脖子,800G 端口一抢而空、1.6T 已经排上量产的档期。这篇专看 AI 集群怎么把网络带宽和时延逼到墙角,交换机和光模块怎么从配角变主角,不重复前面三张网的全景,只盯「为什么 800G 刚坐稳、1.6T 就来抢班」这件事。
网络从配角变主角的本质不是「带宽更大」,而是 AI 把 scale-out 大集群的通信开销逼成算力瓶颈本身。800G 成为 2026 主力、1.6T 进入量产元年,交换机芯片(博通 Tomahawk 6 单芯 102.4T)和光模块(LPO/NPO/CPO 三代演进)成了 AI 算力的前置条件。比单卡峰值已经定不了胜负,比的是整柜到整集群能不能把数据喂到计算单元。
一、先看全景,速率代际在加速压缩
把 IDC 最新的数摆一下,反转先发生在交换机市场。2026 年第一季度全球以太网交换机市场 154 亿美元、同比加 39.8%,其中数据中心段 100 亿美元、同比加 61.0%,增速比整个市场快一截。更扎眼的是结构,800G 已经占到数据中心交换机收入的 35.8%,等于刚铺开就成了半壁江山。过去一代 100G 到 400G 走了好几年,400G 到 800G 压缩到一两年,800G 到 1.6T 连过渡期都不想给。光模块这边,800G 仍是 2026 出货主力,1.6T 直接进入量产元年,中际旭创、新易盛、天孚光引擎的量产线已开,华工正源批量供货。行业预测 2027 年 800G 与 1.6T 需求各到 6000 万至 7000 万只,两代同跑而不是简单换代。
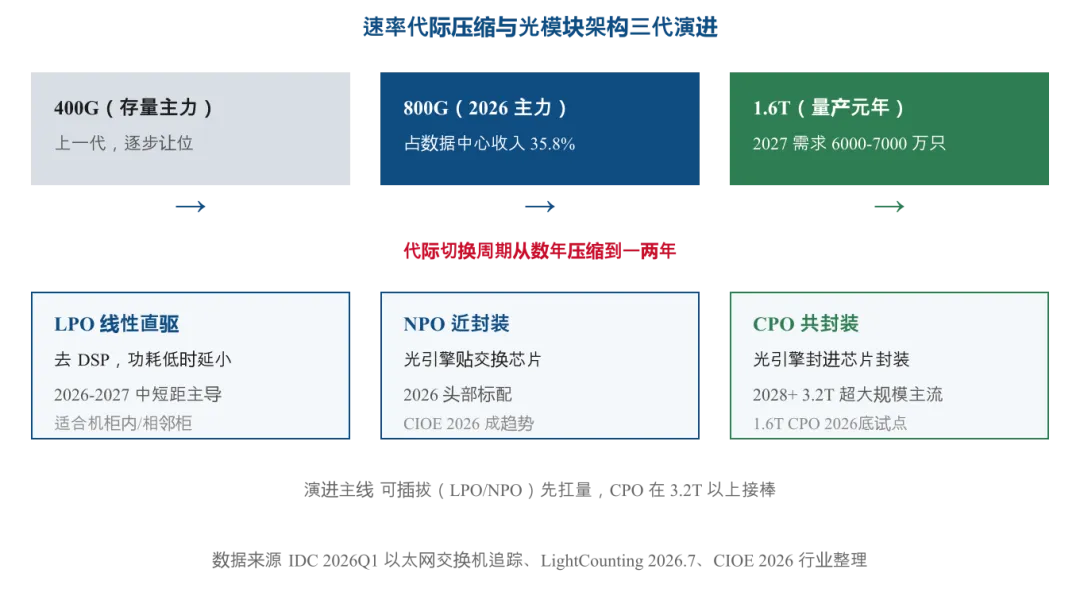
图 1|速率代际压缩加光模块架构三代演进。800G 坐稳主力、1.6T 量产,LPO/NPO 先跑量、CPO 在后段接棒。
说明 上表交换机为收入口径,光模块需求为行业预测区间,非官方强制数。IDC 数据显示 800G 在数据中心交换机收入中已占逾三成,量级与份额以官方季度追踪为准。
二、为什么 AI 非高速网络不可,通信成了算力的一部分
光看速率压缩还不够,得看 AI 到底往网络上压了什么。大模型训练是 scale-out,成千上万张卡要同步梯度,参数、激活、梯度在卡间飞来飞去,通信量和算力同步膨胀。集群一大,通信开销就不再是「顺带」的事,而是吃掉有效算力的真家伙。前一篇聊过,10 万卡的传统堆法 MFU 不足 30%,超节点能拉到 80% 以上,那 50 个点的差距,很大一块就是互联和通信效率给的。换句话说,GPU 再多,网络喂不上,算力就空转。AI 把网络从「连起来别断」重新定义成「算力的前置条件」,这才是配角变主角的根。
一个容易绕的点。网络不只是带宽,时延和零丢包同样要命。训练用集合通信(AllReduce、AllToAll),微秒级抖动都会拖慢整轮迭代;推理的 KV Cache 要在卡间频繁搬,时延直接变响应延迟。所以 AI 网络比的是整条链路,交换机芯片、SerDes、光模块、拥塞控制(如英伟达 SHARP 网内计算、Ultra Ethernet 的可靠传输)一起算,单看端口速率会被误导。
三、三个常见的误判,别踩
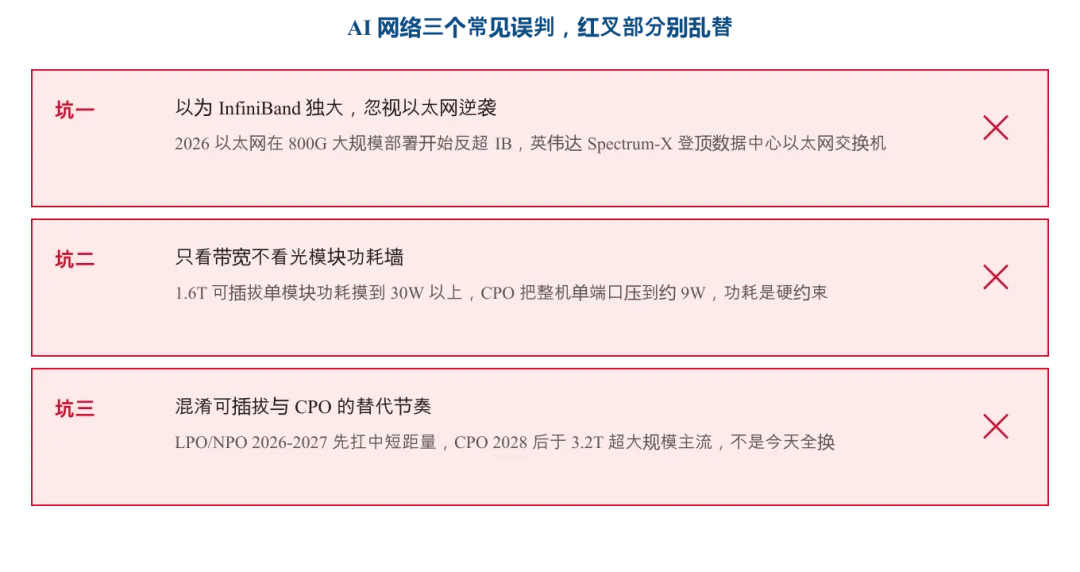
图 2|三个常见误判。以太网在逆袭、功耗是墙、CPO 有节奏,三件事都别想当然。
四、回到数据,交换机芯片、光模块、IB 与以太网怎么摆
把三张关键对照表摆出来,硬件和协议的账才清楚。第一张是交换机芯片,博通 Tomahawk 6 单芯片 102.4Tbps、64 个 1.6T 端口、200G SerDes,已向早期客户送样,搭载系统预计 2026Q4 出货,用 16 个 6.4T 硅光引擎把功耗降约 70%;英伟达 Spectrum-X 基于 Spectrum-4(51.2Tb/s、64×800G),官方称 AI 性能较传统以太网提升 1.6 倍,Quantum-X800 给到 144 个 800Gb/s 端口加 SHARP 网内计算。第二张是光模块架构,LPO 线性直驱去 DSP、NPO 近封装贴芯片、CPO 共封装,英伟达 Quantum 3400 和 Spectrum-X Photonics CPO 从 2026 年 8 月起量产,单台集成 32 颗 3.2T 光引擎、整机 102.4T、单端口约 9W,1.6T CPO 在 2026 底试点、2027 到 2028 规模商用。
说明 上表规格来自博通与英伟达官方披露及行业整理,单芯带宽与端口数为厂商标称,实际部署受整机散热与供电约束。
说明 上表时延为典型区间,来自各协议官方规范与厂商基准,实际受拓扑与拥塞控制影响。2026 年以太网在 800G 大规模部署中开始反超 InfiniBand,但 IB 在超低时延训练后端仍占优。
落到份额,反转最戏剧性的是数据中心以太网交换机这个赛道。IDC 1Q26 口径,英伟达以 21 亿美元、21.5% 份额登顶,同比加 192.7%,把长期领先的 Arista(14.6%)甩在身后,华为 5.8%、HPE 6.4% 紧随。三年前没人会把英伟达和「交换机第一」放一起,AI 把这家 GPU 厂硬推成了网络芯片和整机的大户。光模块上游同样火热,LightCounting 2026 年 7 月预计 2026 以太网光模块销售加 73%,2031 光互连市场约 800 亿美元;CIOE 2026 上 800G 主力、1.6T 导入、NPO 成头部标配;全球数据中心光纤光缆 2025 加 75.9% 到 6960 万芯公里、2026 预计 9160 万芯公里,业内管这叫「光纤到 GPU」。
一个趋势值得记住,交换机和光模块在变成「算力前置件」。过去网络预算是算力之后的零头,现在万卡集群里网络成本占比明显抬升,且成为能否跑满 MFU 的硬门槛。CPO 把光引擎封进芯片封装、单端口压到约 9W,本质是在给「带宽涨、功耗不能涨」找出口。国产这边,华为在数据中心交换机国内连续多年居前,光模块厂商(中际旭创、新易盛、天孚、华工正源)已切入 800G/1.6T 量产,硅光与 CPO 是下一程的卡位点。
五、现场怎么用,两个脱敏案例加一张核对清单
案例一,某新能源车企重保训练集群。客户上万辆车回传数据要训大模型,初版用旧数据中心网跑 RoCE,集合通信抖动大、MFU 上不去。方案改成 800G 叶脊加拥塞控制调优,训练迭代时间降一截,GPU 空转减少。这里最容易踩的坑是只按「端口速率够」采购,没单列 AllToAll 的东向流量和微秒级抖动,结果带宽够时延不够,整轮还是被拖。
案例二,某省级政务云智算中心。新建智算中心要喂千卡到万卡训练,方案是 InfiniBand 或 RoCEv2 双路线论证,最后选 800G 以太网加 SHARP 类网内计算做训练后端,光模块先上 LPO/NPO 中短距、长距留可插拔。这里的关键是别高估旧园区网思路,拿「接入稳定、PoE 够」那套评数据中心 AI 后端,结果零丢包和微秒时延都达不到,训练直接掉速。
把「400G 到 1.6T」落到选型动作上,我习惯走这五步。
- 先定拓扑再定速率。
叶脊还是三层、集群多大,先定 scale-out 规模再谈 800G 还是 1.6T,别上来比单端口数字。 - 算东向流量。
训练 AllReduce/AllToAll 的通信量按算力同步估,微秒级抖动和零丢包要单列,带宽够不够和时延稳不稳是两件事。 - 选互联路线。
超低时延训练后端看 InfiniBand(NDR 400G、XDR 800G),性价比和开放生态看 RoCEv2/Spectrum-X/Ultra Ethernet,按预算和生态挑。 - 看光模块架构节奏。
中短距先 LPO/NPO 可插拔扛量,3.2T 以上超大规模再上 CPO,别把可插拔和 CPO 当成今天全换。 - 压功耗墙。
1.6T 可插拔单模块功耗摸到 30W 以上,整机供电和散热要提前算,CPO 单端口约 9W 是后段出口不是当下必选项。
六、选型避坑清单
七条,照着过一遍。
网络已从配角变主角,AI 把 scale-out 通信开销逼成算力瓶颈本身,比单卡峰值定不了胜负,比的是整集群喂数据能力。 速率代际在加速压缩,800G 成 2026 主力(占数据中心交换机收入 35.8%),1.6T 进入量产元年,2027 两代需求各 6000 万至 7000 万只。 别以为 InfiniBand 独大,2026 以太网在 800G 大规模部署开始反超 IB,英伟达 Spectrum-X 以 21.5% 登顶数据中心以太网交换机。 别只看带宽看光模块功耗墙,1.6T 可插拔单模块功耗摸到 30W 以上,CPO 把整机单端口压到约 9W,功耗是硬约束。 别混淆可插拔与 CPO 节奏,LPO/NPO 2026-2027 中短距主导,CPO 2028 后于 3.2T 超大规模主流,不是今天全换。 交换机芯片看博通 Tomahawk 6(单芯 102.4T、64×1.6T、功耗降约 70%)与英伟达 Spectrum-4/Quantum-X800,光模块厂中际旭创/新易盛/天孚/华工正源已切 800G/1.6T。 互联对照要记牢,InfiniBand NDR 400G/XDR 800G 子微秒、Spectrum-X 约 1.5 至 2.5μs、RoCEv2 调优 2 至 5μs、Ultra Ethernet 1.0 从 800G 起,按场景挑路线。
最后一句交叉验证的笨办法。交换机市场和份额优先看 IDC 季度追踪报告原文,800G 占比与英伟达登顶以 IDC 1Q26 为准。光模块需求与 CPO/LPO/NPO 节奏看 LightCounting 2026.7 与 CIOE 2026 行业整理,厂商规格以博通、英伟达、中际旭创、新易盛等官方披露为准。IB 与以太网时延对照看各协议官方规范与厂商基准。不同来源浮动处只写区间与名次,公开核不到的按未披露处理,不推测也不填补。
下篇预告|卷二第 5 篇,趋势判断继续。从「堆卡、堆系统、堆存储、堆网络」往后看,智算中心的供电机柜和液冷怎么从配套变瓶颈,以及白盒与品牌交换机怎么分层。
这些数都是从哪儿来的
IDC《Worldwide Quarterly Ethernet Switch Tracker》2026Q1,全球以太网交换机 154 亿美元(+39.8%),数据中心段 100 亿美元(+61.0%),800G 占数据中心收入 35.8%;数据中心以太网交换机英伟达 21.5% 第一、Arista 14.6%、华为 5.8%、HPE 6.4%,英伟达同比 +192.7%。 博通官方披露与行业整理,Tomahawk 6 单芯片 102.4Tbps、64×1.6T 端口、200G SerDes、16 个 6.4T 硅光引擎、功耗降约 70%,早期客户送样、系统 2026Q4 出货。 英伟达官方资料,Spectrum-4 51.2Tb/s、64×800G,Spectrum-X AI 性能较传统以太网 +1.6 倍;Quantum-X800 144 个 800Gb/s 端口加 SHARP;Quantum 3400 / Spectrum-X Photonics CPO 2026 年 8 月起量产,单台 32 颗 3.2T 光引擎、整机 102.4T、单端口约 9W。 LightCounting 2026 年 7 月预测,2026 以太网光模块销售 +73%,2031 光互连市场约 800 亿美元;CIOE 2026 行业整理,800G 主力、1.6T 导入、NPO 成头部标配。 光模块厂商披露与行业整理,中际旭创、新易盛、天孚光引擎 1.6T 量产,华工正源批量供货;2027 年 800G 与 1.6T 需求各 6000 万至 7000 万只(区间预测);LPO/NPO 2026-2027 中短距主导,CPO 2028 后 3.2T 以上超大规模主流,1.6T CPO 2026 底试点、2027-2028 规模商用。 InfiniBand 与以太网互联规范,NDR 400Gb/s、XDR 800Gb/s、子微秒时延、SHARP 网内计算;Spectrum-X 约 1.5 至 2.5μs;RoCEv2 调优约 2 至 5μs;Ultra Ethernet Consortium 1.0 规范(800G 起、8 万至 25.6 万端口)。 行业研究(光纤光缆与「光纤到 GPU」),全球数据中心光纤光缆 2025 加 75.9% 至 6960 万芯公里、2026 预计 9160 万芯公里;华为国内数据中心交换机连续多年居前(份额以官方口径为准)。
本文聚焦 AI 集群把网络带宽和时延逼到墙角、交换机与光模块从配角变主角的趋势,不重复网络三张网(园区/数据中心/无线)的全景。份额与速率数字均标统计机构、口径和时间段,不同来源浮动处只写区间与名次,公开核不到的条目按未披露处理,不推测也不填补。数据截止 2026 年 10 月 22 日。
这一篇把网络从「连设备的线」讲成「算力的前置条件」,结论其实朴素,GPU 再多,网络喂不上,算力就空转。
你要是手头有看不懂的智算中心网络选型或交换机配置,甩给我,我有空顺手拆给你看。