ARTICLE · 1255914
最强大的文档解析模型:OCRia‑1
技术洞察|智能体工程实战
做 RAG、文档 Agent 的同学应该都深有体会:文档解析是整个链路的入口,入口质量直接决定了后面检索、推理的上限。 普通文本 PDF 还好处理,一旦遇到企业真实文档:财务报告、保险表单、税务文件,里面大量嵌套表格、合并单元格、各类图表、数学公式,传统 OCR、通用 VLM 很容易翻车。表格结构错乱、图表信息丢失、格式符号被抹平,后续不管大模型多强,拿到残缺的原始素材,结果自然不可靠。
10 月 22 日 LlamaIndex 正式发布 OCRia‑1,一个 40 亿参数的视觉语言模型,作为 LlamaParse 的底层能力,主打文档解析,在准确率、延迟、成本三个维度做整体优化。 有意思的点在于,它只有 4B 参数,却在多个公开基准跑出了显著高于更大参数量模型的结果。本文基于官方发布材料做梳理,同时结合工程视角聊聊它的能力边界,以及对我们做文档类 Agent 的实际意义。
说明:本文信息来源于 LlamaIndex 官方博客,文中对比数据均来自官方公布的基准测试结果,实际业务落地建议自行做验证评测。
一、基准表现:4B 参数,多项榜单领先
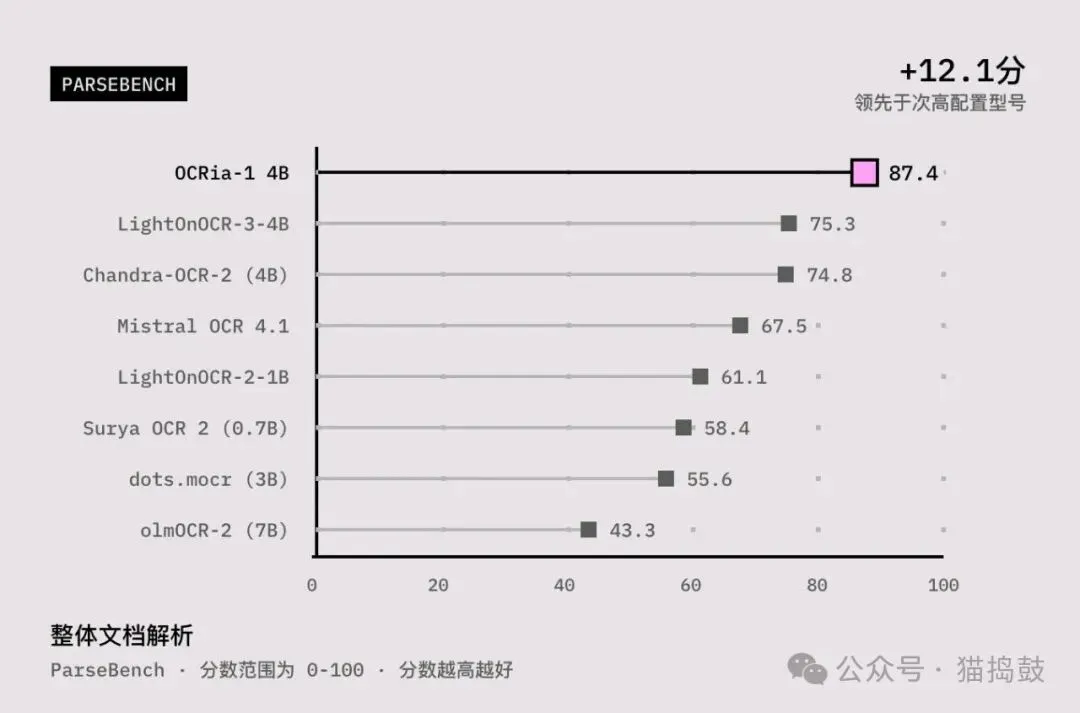
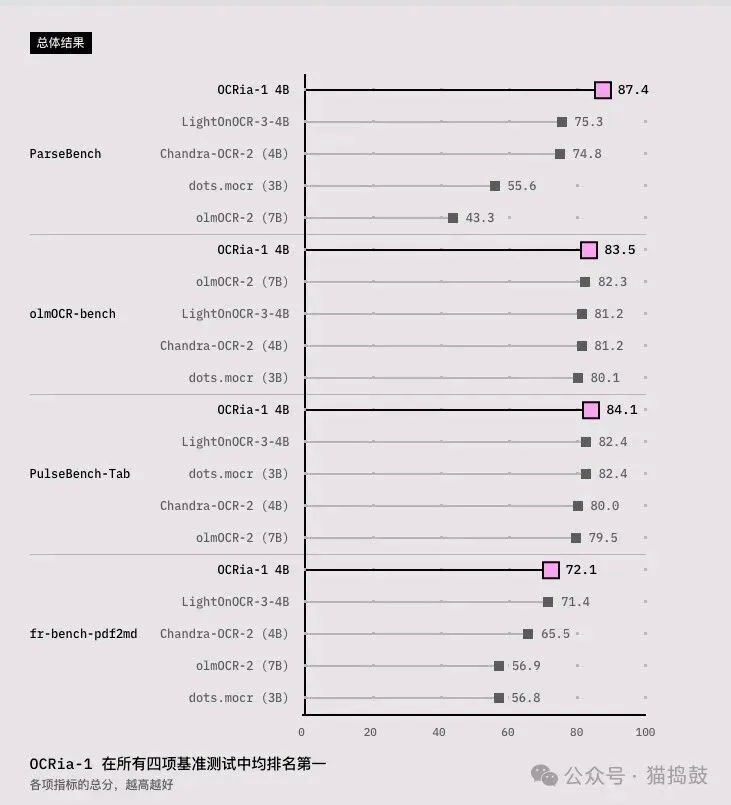
OCRia‑1 在 ParseBench、olmOCR‑bench、PulseBench‑Tab、fr‑bench‑pdf2md 这几套文档解析基准上拿到不错成绩。 在 ParseBench 综合评测中,总分 87.4,相比第二名高出 12.1 分。这套评测覆盖文本、格式、表格、图表多维度,测试样本包含多语言、不同类型文档页面。
其中表格与图表是它重点强化的部分:
- 表格解析
在olmOCR‑bench(92.9)、PulseBench‑Tab(84.1)、fr‑bench‑pdf2md 等第三方表格专项评测全部处于前列。 复杂表格处理一直是文档解析的硬骨头:嵌套表头、合并单元格、不规则网格,一旦解析出错,会直接带来财务、业务数据对比错误。OCRia‑1 的设计目标就是尽量保留单元格之间的关联关系,这对金融、保险类业务文档非常关键。 - 图表解析
ParseBench 图表维度得分 85.1,第二名仅 66.1,传统解析器得分接近 0。 很多解析工具只能识别图表图片,输出一句文字概括,拿不到具体数据点。OCRia‑1 可以把图表转换为带数据点的 HTML 表格,保留数值、系列、标签之间的对应关系,方便后续做计算、分析。 - 格式与数学符号保留
多数解析器会直接丢弃上标、下标、删除线、复选框这类排版信息,数学公式直接转成纯文本。OCRia‑1 支持输出 Markdown / HTML 格式标记,数学公式输出 LaTeX。ParseBench 格式维度得分 83.4,第二名 67.9。
基准测试有渲染条件、数据集的约束,官方说明所有模型统一采用 1288px 的渲染标准做对比。基准分数好看不等于线上业务开箱即用,真实业务依然要做自己的评测集。
二、训练思路:数据集 + SFT + RLVR 强化学习
官方把效果的提升主要归因于数据构建与后训练流程。
训练集规模超过 10 万页文档,重点瞄准现有 VLM 容易出错的场景:跨页长表格、密集图表、数学符号、多语言文本、质量较差的扫描件。
数据集来源分为两块:
真实业务文档,配合人工标注与 VLM 辅助审核; 合成文档生成器,人为改变文档复杂度、布局多样性,用来补全真实世界里的长尾样本。
后训练采用两阶段:
- 监督微调 SFT
:建立基础文档解析能力; - RLVR(带可验证奖励的强化学习)
:针对表格、图表这类复杂任务设计奖励信号,进一步提升泛化能力。
简单理解:不只是教模型“输出长文本”,而是通过可校验的奖励,强制模型把表格单元格关系、图表数据对应关系做对。
三、对工程落地的实际意义
我们做文档 Agent、企业 RAG,经常遇到两类痛点: 一类是追求效果,上大参数量 VLM,解析质量上来了,但推理成本、延迟很高,大批量文档处理吃不消; 另一类是为了成本,用传统 OCR,遇到复杂表格图表直接报废,后面 RAG/Agent 再怎么调提示词都救不回来。
OCRia‑1 的定位,就是试图在小参数量模型上,补齐复杂文档的短板,兼顾精度、速度、成本,已经内置在 LlamaParse 服务中对外提供。
但这里也要客观看待几个现实边界:
基准测试不等于真实业务。基准样本是筛选过的,企业内部文档会有大量扫描模糊、手写、版式极度混乱的极端case,依旧会出错; 表格、图表解析依然会有幻觉。即便分数很高,涉及财务、业务关键数据,不能直接采信解析结果,重要数据必须做二次校验; 它解决的是“文档转结构化文本/markdown”这一个环节,完整文档 Agent 链路还包括切片、检索、记忆、工具调用、结果校验,解析只是入口。入口质量提升,会降低下游的难度,但不能替代后面整套评估体系。
四、哪些场景可以重点关注,哪些不要过度期待
✅ 更适合的场景
大量 PDF 财报、保险表单、税务文档,存在大量嵌套表格、长表格; 论文、技术材料,需要保留公式、上下标、排版格式; 图表多,需要提取图表内具体数值,而不是只看图片描述; 大批量文档解析,对成本、延迟敏感,不想堆超大 VLM。
⚠️ 不要过高期待
极度模糊、扭曲、低质量老旧扫描件,依然会存在识别错误; 不是万能,输出的表格、图表数据,业务使用时必须校验; 它是解析模型,不解决后续 RAG 的召回、Agent 的规划幻觉问题。
结尾
文档解析看似是预处理环节,实际是企业文档智能体的地基。很多项目上线之后效果差,团队反复调 prompt、调 Agent 架构,回头溯源才发现源头是解析把表格、格式破坏了。
OCRia‑1 代表一个趋势:专门面向文档任务的小专精 VLM,正在逐步替代通用大模型做文档预处理。4B 参数拿到高基准分数,核心不在于模型参数量,而在于针对性的数据构造和强化学习奖励设计。
有需要的同学赶快去试一试吧