ARTICLE · 1285742
1.3B文档解析模型实测:榜单第一,表格翻车,锅不在它
照例交代:下面的数字都是老蝈在自己机器上跑出来的,测砸了的也照实写。
中位 F1 0.985。 297 页真实中文手册,一页不落跑完,跟 PDF 文本层逐字对账的中位得分。这份成绩单的持有者 OXR-1.0,是个 1.3B 的开源文档解析模型,宣传稿说它在三个全球基准上全是第一。
0.675 到 0.949。 同一页表格加正文的混排版面,走官方免费 API 全管线是 0.675,把版面模块拆掉、让裸模型整页直推,是 0.949。复读四成的糟烂输出,一夜之间变成几乎满分——翻案的方向和直觉相反:翻车的不是模型,是官方 pipeline。
105 分钟到 6-7 分钟。 297 页全册跑完的耗时,前者是双卡批处理,后者是单卡 vLLM 服务化,中间隔着一次插件移植。
结局先剧透:文本转写,宣传没吹牛,中文手册上几乎零错字;表格是真实短板,但拆开看是管线级缺陷,有兜底就有救;免费通道有个比分数严重得多的问题——它会把你的文档图片上传到对方服务器。这篇把从刷到宣传稿到私有化部署跑通的全过程摊开:考卷怎么出、翻车翻在哪、两次误判之后真凶怎么锁定的。
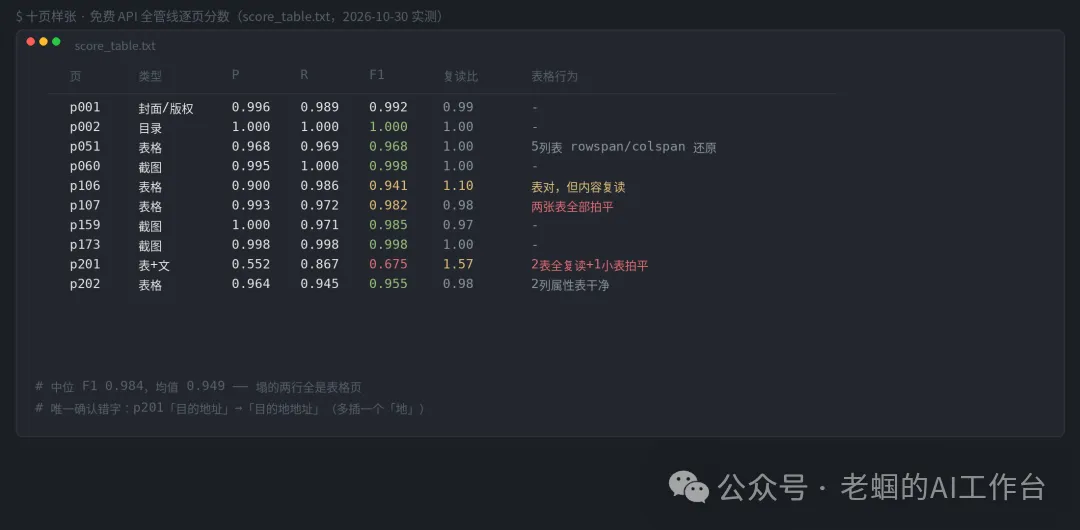 图1|免费 API 十页样张的逐页分数:文本页齐刷刷 0.98+,塌的两页全是表格
这篇怎么读
第 2 节 考卷与考生:宣传稿说了什么,我出了张什么卷子 第 3 节 第一轮:免费 API,文本封神,表格翻车 第 4 节 翻案:复读的锅,pipeline 背——一页对照实验定案 第 5 节 上机:八卡全灭、两次误判、一个真凶 第 6 节 全册 297 页:105 分钟和 3 个崩坏页 第 7 节 vLLM 化:移植三个坑,换 7 倍速 第 8 节 复测步骤:你手头有 PDF 就能跑 第 9 节 带走这张清单
2. 考卷与考生
先交代起因。10 月 30 日下午,我在公众号刷到一篇宣传稿:SoMark 团队开源了 OXR-1.0,号称"精度与速度双 SOTA",在 OmniDocBench、olmOCR-Bench、DocParsingBench 三个基准上全排第一,OmniDocBench 97.18 分,单页 2-3 秒(官方旗舰卡口径),能出 13 类元素的版面坐标。按这个号的规矩,榜单数字先不信,但东西值得测——手头正好有一份真实在用的中文产品手册,297 页,表格、截图、纯文本什么版面都有。这就是考卷。
考生长这样:OXR-1.0,1.3B 参数,视觉塔是 Siglip2-NaViT(Qwen2.5-VL 式的窗口注意力),语言底座是 Qwen3-0.6B。两处口径先摆出来,不下结论:README 说模型"从零开始预训练",但 config.json 里 llm_config 一栏白纸黑字写着 Qwen/Qwen3-0.6B-Base——这两句话怎么统一,模型卡没解释,你自行判断。对我更有用的两个事实:BF16 权重只有 3.07GB,代码纯 Python 无编译算子——后面上昇腾全靠这两条。
考卷先做了一次加工:手册原文是 docx,我用 pandoc 转 HTML、Chrome 无头打印成 297 页 PDF。先自我打假:这是重排版,不是原版 Word 排版,部分外链图在重排中退化成了路径文本——但这些退化同样计入标准答案,对考生公平。然后抽 10 页样张:封面、目录、3 个表格页、3 个截图密集页、2 个纯文本页。判卷基准用 pdftotext 提取的同页文本层,指标是归一化后的字符级 P/R/F1,外加一个复读比(输出长度除以基准长度,超过 1 就是在复读)。
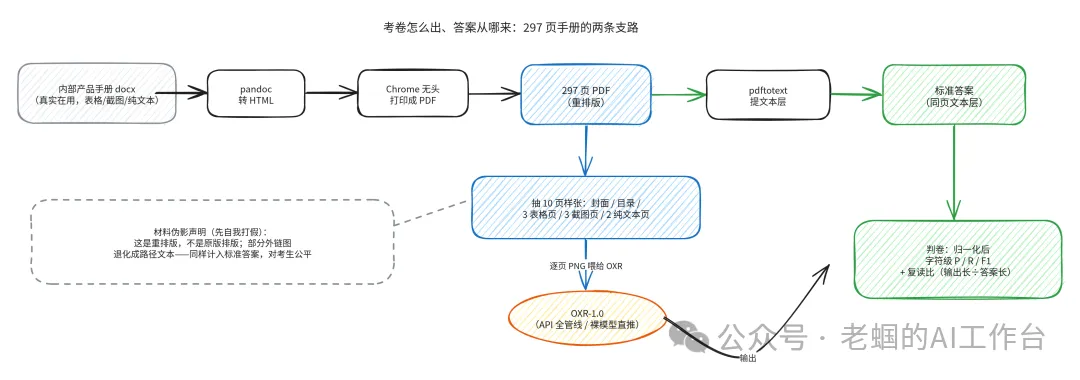 图2|考卷制作与判卷:docx 重排出 297 页,pdftotext 的文本层当标准答案
3. 第一轮:免费 API,文本封神,表格翻车
官方提供免费 API,走的是全管线:D-FINE 版面分析、分区识别、阅读序拼接、去重后处理。10 页跑完,账面如下。
文本转写,属实且拔尖。目录页 F1 = 1.000,编号、页码、层级全对,比 pdftotext 的原始输出还干净;版权段落、UI 术语、路径文本全部完整。10 页里唯一确认的错字,是"目的地址"里多插了一个"地"。有意思的是另一处"错字":正文里的"忠提供",我以为是它抄错了,对着原文档一查——原文档自己就写着"忠提供",OXR 忠实转写,一个字没改。 误报抓得越较真,越说明正文页的干净是真干净。
表格页是另一番光景。10 页样张里有 5 页带着表格——设计时按主导版面只归了 3 个表格页,判卷时另外两页也翻出了表。这 5 页,上限确实高:一张 5 列的复杂矩阵表,rowspan、colspan 全部还原成结构正确的 HTML,这是很多商业工具都做不到的。下限也确实低,两种翻法各占两页:
拍平。 表格结构整个消失,内容全在,行列配对关系没了——"哪个分类对应哪个说明"这种关系,RAG 切块之后就再也还原不回来。
复读。 表格输出完,单元格内容又作为散文本重复一遍。最惨的一页 p201,两个表加上正文混排,输出长度是标准答案的 1.57 倍,精度被直接拖到 0.552,F1 只有 0.675。同一页还有 13 个 H1——表头和字段名被成排抬成了一级标题。
通道体验也给三个数字:中位 94 秒一页(含排队),最快 19 秒,最慢 332 秒;并发等于 1,同时发两个请求直接 429;最要命的是——内嵌截图会被上传到对方服务器并返回图链。免费通道官方自己都说"不建议用于线上环境"。内部资料走这个通道等于文档资产外发,这条红线后面第 9 节还要收进清单。
十页里最值钱的疑点是复读:模型明明会做表(矩阵表都还原对了),为什么输出会自己复读自己?这个细节先记住,下一节它要翻案。
4. 翻案:复读的锅,pipeline 背
对照实验只换解析形态:同一页 p201,不走 API 的全管线,把权重拉到本地,裸模型整页直推——没有版面分析,没有去重后处理,一句固定指令"Recognize the whole page content of the image.",让模型自己看整页输出整页。
结果:P 0.956,R 0.943,F1 0.949,复读比 0.99,零复读。两个表格都在,行列关系都在。前一天还被判 0.675 的同一页,换个通道直接逼近满分。
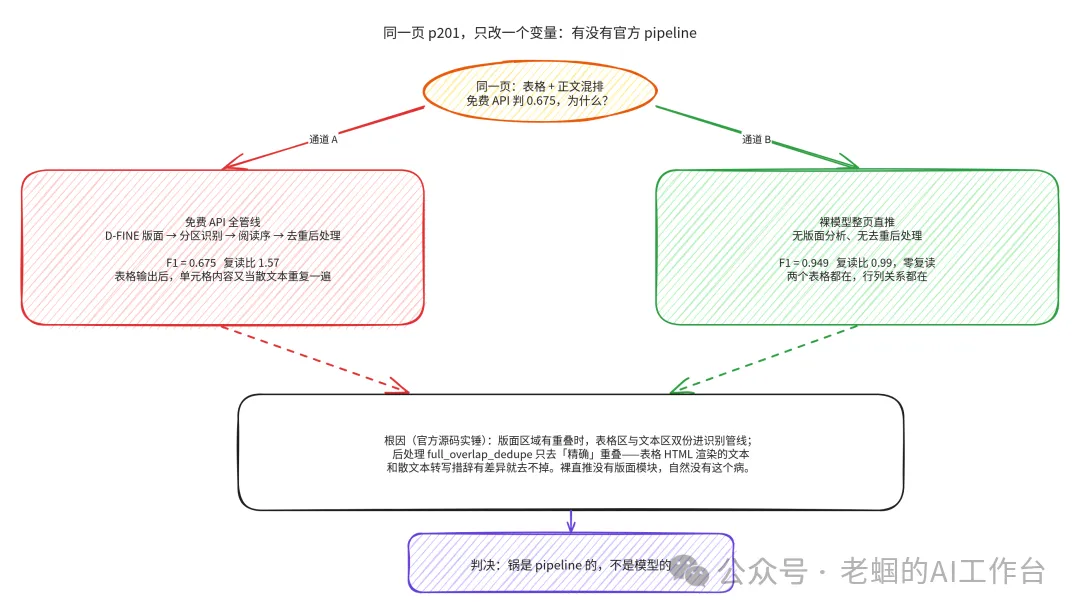 图3|同一页 p201 的两条通道:API 全管线 0.675 复读 1.57,裸模型直推 0.949 零复读
复读的机理,官方源码里能直接看到:版面区域有重叠时,表格区和文本区会双份进入识别管线;后处理的去重函数 full_overlap_dedupe 只去精确重叠——表格 HTML 渲染出来的文本和散文本转写的措辞只要有差异,就去不掉。双份内容叠加输出,就是读者看到的复读。裸模型直推压根没有版面模块,自然没有这个病。
结论反转:缺陷出在官方 pipeline 的版面去重,不是模型本身。 对手册类文档,整页直推已经又干净又强;全管线只在需要 13 类元素坐标、需要版面结构时才值得开,而且表格页必须自己加复读兜底。标题过度提升是另一个要自己收拾的尾巴:表头字段名常被抬成 H1,下游消费前做一层标题归一化。
这个翻案也顺手回答了第 3 节埋的问题:模型会做表,pipeline 不会交卷。
5. 上机:八卡全灭、两次误判、一个真凶
数据不能外发,答案只剩私有化。目标机器是公司一台 8 卡昇腾服务器,先看了眼卡位:4 张卡上每个只挂着 2.8G,剩约 30G 空闲——比想象中宽松。3.07GB 的 BF16 权重、纯 Python 代码、Qwen3 底座,没有任何 CUDA 专属算子,上 NPU 的预期很乐观。
然后现实给了当头一棒:新起的容器里,8 张卡全部初始化失败,报错 aclInit 507899,设备数 0。更诡异的是宿主机上看不到任何进程持有这些卡,只有每卡约 2.8G 的无主占用。
接下来是两次误判,代价各一轮:
误判一:卡被业务占用。 直觉合理——卡上有残留占用嘛。申请重启了这台机器。重启完,业务容器挨个起来,初始化全都成功;我的新容器,8 张卡依旧全灭。重启把"占用"这个假设直接证伪了:如果是老进程占着,重启之后最先起来的业务怎么没事?
误判二:镜像的 CANN 和驱动不匹配。 换了公司内部另一个现成的昇腾镜像,同样失败。方向又错了。
真凶是 dmesg 里的一句话:uda_occupy_dev_by_ns: Conflict open udevid。翻译过来:一张卡同一时间只归属一个容器命名空间(ns)。重启后先初始化的业务容器把 8 张卡全部占籍,后来者只要是新的命名空间,一律拒绝。之前看到的"无进程但有残留占用",是占用者上下文,不是泄漏;失败的初始化尝试自己还会留下新的占用登记——观察到的占用者 ID 会漂移,机理全对上了。
解锁实验验证了这个判断:docker exec 进持有卡的业务容器里,初始化它自己的那张卡——枚举到全部 8 卡,无任何冲突。同一个 ns,放行。最终配方四件:在卡主容器内起推理、source 它的环境脚本、指定可见卡号、挂载收窄。另有一坑最隐蔽:整页模式下模型吐 <|im_end|> 结尾,但默认的停止符列表里只有 <|endoftext|>,不把 eos_token_id 配齐,模型会一路刷到输出上限——同一个目录页,370 秒变 28 秒。
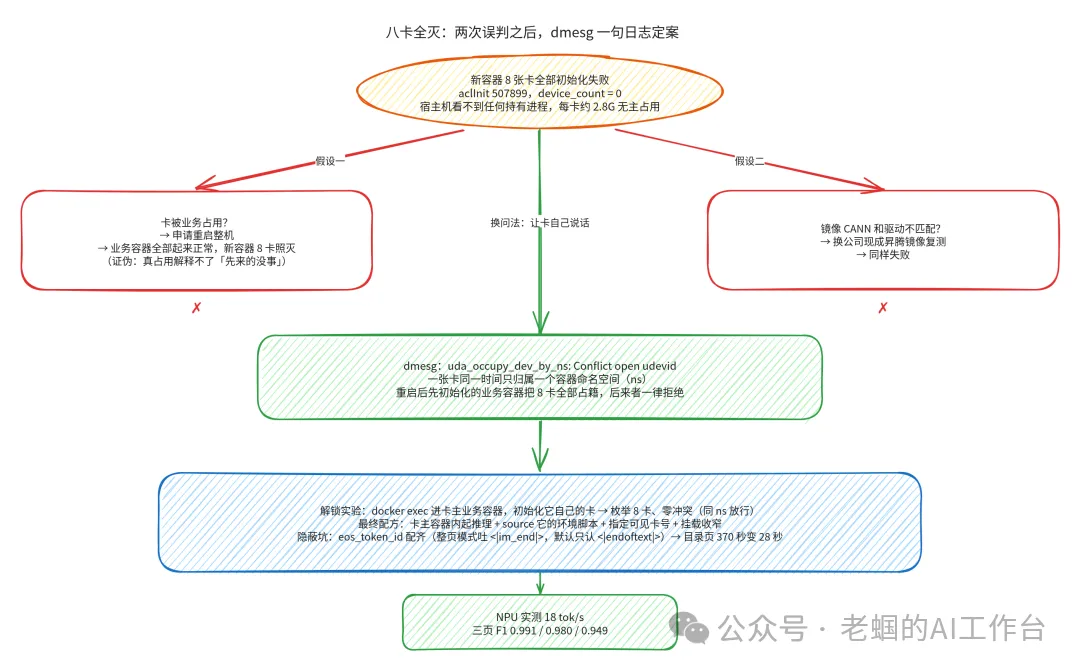 图4|八卡全灭的排障路径:两次误判之后,dmesg 一句日志定案
NPU 实测三页:18 tok/s,三页 F1 分别 0.991、0.980、0.949。最硬的一条对账:p201 在 NPU 上的输出和本地 CPU 直推逐字节一致(归一化后长度同为 1246),贪心解码的确定性把"质量没有因移植劣化"钉死了。p002 上比 API 版多出两个滑字("重启"变"重后"),幅度可忽略。
6. 全册 297 页:105 分钟和 3 个崩坏页
单卡跑通之后上双卡:297 页渲染成 150dpi 图片,两个 worker 各占一卡、模型常驻、页级并行、断点续跑。105 分钟,297 页零失败。
判卷结果:均值 F1 0.958,中位 0.985。126 页得分不低于 0.99,107 页在 0.95 到 0.99 之间——近八成的页面接近满分。45 页里含 71 张表格。全册只有 3 页低于 0.60,而且三页是同一个病:正文输出正常,贪心解码撞上截图里的特殊文本(比如一串超长的"教科书/某某考试卷_专题八"式文件名),开始无限复读,一直刷到 6144 的输出上限才停——输出长度是标准答案的 9 到 13 倍。这是整页直推模式自己的缺陷,全管线的去重兜底恰好能挡住它,所以免费 API 那轮没暴露。生产上两层缓解:repetition_penalty 设 1.05 到 1.1,或者输出超长直接截断、与版面检测交叉校验。
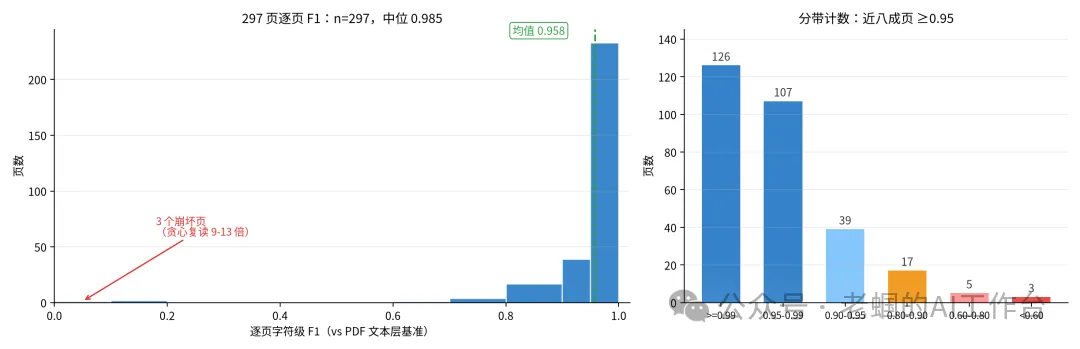 图5|297 页的 F1 分布:八成页面 0.95 以上,3 个崩坏页全是复读
其余低分页(0.7 到 0.8 那档)翻原输出看,多为提前收尾或标准答案里的重排伪影,不是复读。测过的是这 297 页、这台机器、这个配方;别的手册别的机器,看方向不看幅度。
7. vLLM 化:移植三个坑,换 7 倍速
105 分钟跑一册,批处理形态够用但不痛快。官方的 vLLM 插件把吞吐打上去的路是现成的——麻烦在版本:插件钉死 vLLM 0.25.1 加 CUDA,而这台机器的 CANN 9.1 上限是 vllm-ascend 0.23。硬装没有路,只能移植。
移植面出乎意料小:vllm 0.23 已经自带了 Siglip2NaViT 视觉塔注册和全套新的多模态接口,真正 0.25 专属的只有两个并行标注包装函数,删掉即可。真正的坑在运行时,三个:
坑一:VLLM_PLUGINS=oxr 一设,vllm-ascend 的平台插件被连带过滤,引擎报"Failed to infer device type"。这个变量的语义是白名单,不是追加——删掉它,默认全加载,即愈。
坑二:transformers 5.5.4 的新图像后端把字符串 "bilinear" 直接递给 torchvision,而 torchvision 版本和 torch 锁死不能单升。绕法是在移植版 processor 里按 preprocessor 配置手工搭像素管线:PIL 缩放、归一化、通道调序,语义与原后端一致。
坑三最小:0.23 还没有 --disable-log-requests 这个开关,删参数即可。
服务起在业务容器内显存充裕的一张卡上,两分钟就绪。账面:单流解码约 125 tok/s,是 eager 直推 18 tok/s 的 7 倍;4 并发聚合 339 tok/s,折合每秒 0.79 页;整册 297 页 6-7 分钟跑完,单卡。质量抽查 p201,F1 0.945,对齐(引擎数值差异,可忽略)。测速时另有个小陷阱:缓存页命中会跳过 prefill(含视觉编码),数字虚高——基准必须用没请求过的页。
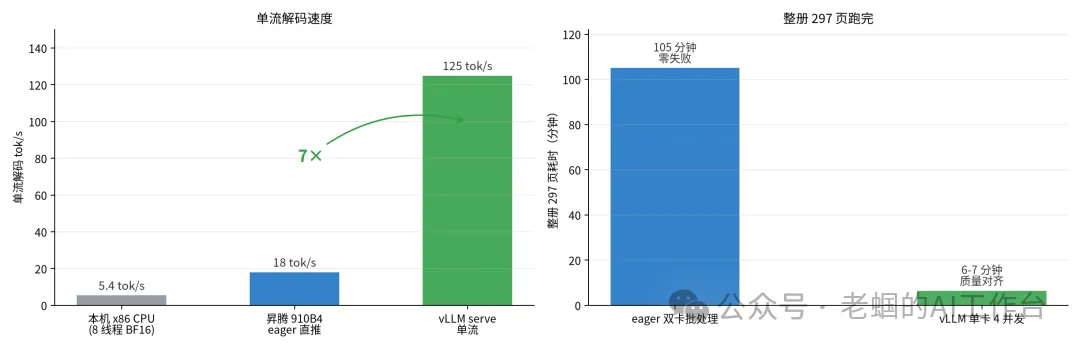 图6|三条通道的速度账:CPU 5.4、NPU eager 18、vLLM 约 125 tok/s;整册 105 分钟对 6-7 分钟
8. 复测步骤
环境与版本:OXR-1.0(ModelScope SoMark/OXR-1.0,2026-10-20 发布);本文 CPU 数字出自 x86 8 线程 BF16,NPU 数字出自昇腾 910B4 单卡,vLLM 数字出自 vllm 0.23.0 + vllm-ascend 0.23.0 + transformers 5.5.4;截至 2026-10-31 可复现。
最小命令序列(出自本次真实执行记录,可复制):
# 权重与模型代码:官方 ModelScope 仓库 SoMark/OXR-1.0,git clone 或 modelscope download 任选
# 目录布局对齐本文脚本:仓库放进 models/OXR-1.0,仓库根的 configuration_oxr.py /
# modeling_oxr.py 打包成 models/oxr_pkg(内容就是这两个文件加一个 __init__.py)
mkdir -p models
git clone https://www.modelscope.cn/SoMark/OXR-1.0.git models/OXR-1.0
# 免费 API 全管线(对照组;再提醒一次:图片会上传对方服务器,只放公开材料)
curl -sS -m 1200 -X POST "https://free-oxr.somark.cn/api/v1/parse/sync" \
-F "file=@page201.png" -F "api_key=dummy" -F "output_formats=markdown"
# 裸模型整页直推(实验组)
python3 local_oxr.py page201.png out_p201.md
local_oxr.py 是套在官方 modeling_oxr.py 外面约 30 行的壳,全文照贴(真实执行版,路径即上面的布局):
import sys, time, torch
sys.path.insert(0, 'models')
from PIL import Image
from oxr_pkg.configuration_oxr import OXRConfig, Siglip2NavitConfig
from oxr_pkg.modeling_oxr import OXR, Siglip2NavitModel
from transformers import AutoModel
AutoModel.register(Siglip2NavitConfig, Siglip2NavitModel)
t0 = time.time()
model = OXR.from_pretrained('models/OXR-1.0', torch_dtype=torch.bfloat16)
model.eval()
model.indicator_token_indices = torch.arange(model.config.visual_vocab_size - 4,
model.config.visual_vocab_size, dtype=torch.long)
print(f'load {time.time()-t0:.1f}s', flush=True)
png, out = sys.argv[1], sys.argv[2]
img = Image.open(png)
messages = [{"role": "user", "content": [
{"type": "image", "image": img},
{"type": "text", "text": "Recognize the whole page content of the image."},
]}]
t0 = time.time()
input_ids, pixel_values, grid_thws = model.preprocess_inputs(messages)
print(f'preprocess {time.time()-t0:.1f}s', flush=True)
t0 = time.time()
with torch.no_grad():
out_ids = model.generate(inputs=input_ids, pixel_values=pixel_values, grid_thws=grid_thws,
do_sample=False, max_new_tokens=4096)
dt = time.time() - t0
text = model.text_tokenizer.batch_decode(out_ids, skip_special_tokens=True)[0]
open(out, 'w', encoding='utf-8').write(text)
ntok = out_ids.shape[-1]
print(f'generate {dt:.1f}s ({ntok/dt:.1f} tok/s, {ntok} tok) -> {out}', flush=True)
打分同一套口径:双方去掉空白与 markdown 标记后,difflib.SequenceMatcher 数匹配字符,P/R/F1 与复读比由此而来——拿任意对齐工具实现同口径即可。
数据来源:本文手册涉内部材料已脱敏不提供,复测用任意公开中文 PDF 同样成立——重排转 PDF、pdftotext 出基准文本层,管线一致。
预期结果对照:纯文本页 F1 应落在 0.97 以上;表格混排页 0.90 到 0.98,带 rowspan/colspan 的复杂表结构应还原;若走免费 API 且表格页出现复读,复读比会明显大于 1(本次样本 1.10 与 1.57)——落在这几条带内即复现成立。
跑不出来评论区贴报错,我帮你对。
9. 带走这张清单
1. 榜单第一要测,但测完该认要认。 这次宣传没有造假痕迹:三个基准第一没法独立复核,可真实手册上文本 0.98、部署全跑通,方向与宣传一致。先入为主地信和先入为主地疑,是同一种偷懒。
2. 管线和模型分开评。 一页对照实验(全管线 vs 裸模型直推)就把 0.675 翻案成 0.949——交付物是"模型+管线"的整体,但定性缺陷得拆开找主犯,兜底才知道加在哪层。
3. 免费通道等于数据外发。 文档图片上传到对方服务器是这类免费解析 API 的默认行为,内部资料一页都别给。私有化门槛没想象中高:3GB 的小模型,一张卡的事。
4. 昇腾排障,先 dmesg 再猜。 "一卡一命名空间"的占籍机制不写在任何 README 里,但 dmesg 一句 Conflict open udevid 就能省掉两轮误判——包括一次昂贵而无用的重启。
5. 贪心解码不设防。 复读到输出上限的崩坏页,免费 API 全管线没暴露、裸推理全暴露——兜底(repetition_penalty、超长截断)要放在自己这层,别指望别人的管线替你防。
最后留个问题:你手头的 RAG 知识库,文档解析这一层现在用的是谁——踩过表格拍平或者复读的坑吗? 评论区聊聊。
(数据说明:本文全部数字来自本机与脱敏测试环境的实测;测试材料为一份内部产品手册的重排版,已脱敏不外发;OXR-1.0 为公开开源模型,2026 年 10 月 30 日至 31 日实测;榜单数字引自官方宣传稿,未独立复现,正文已注明。)
我是老蝈,不信 PPT,只信实测;数据我自己跑的,结论我自己担。下期想看我测什么,评论区点名;手上有拿不准的 AI 问题也砸过来,我测完告诉你答案。