文档文本内容
106.线性回归分析与独立性检验
一.基本原理
一.相关性检验
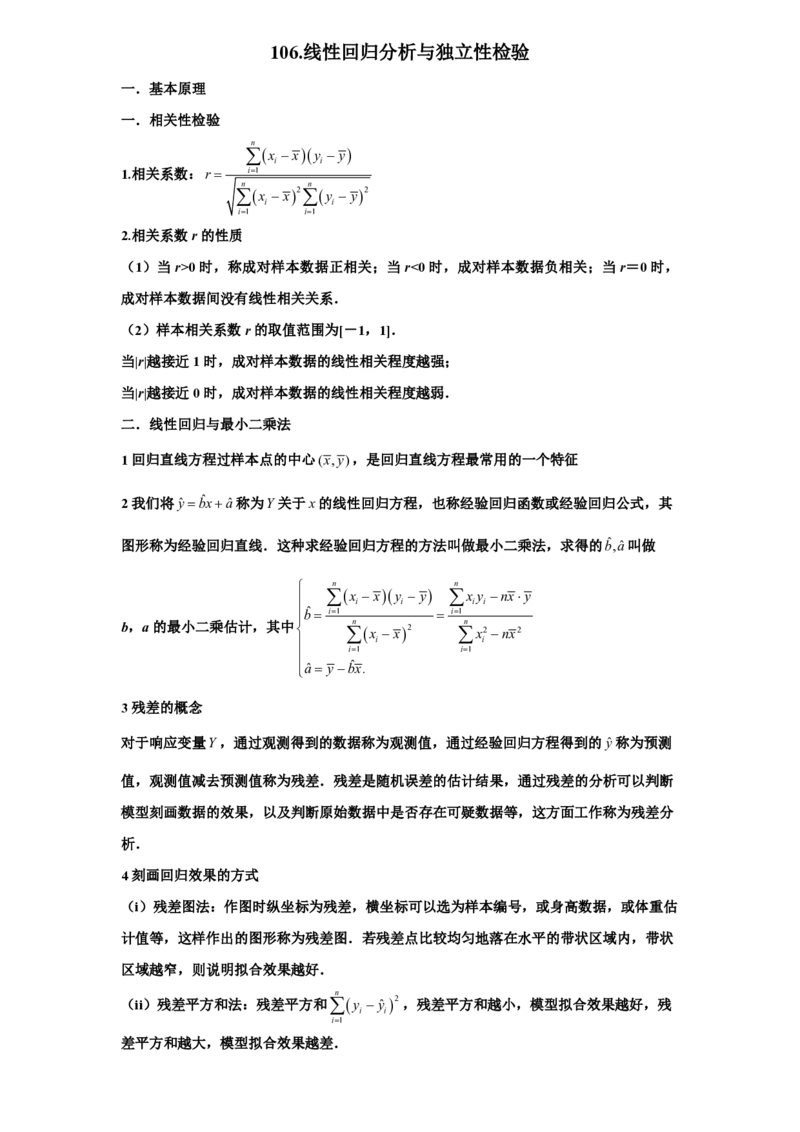
1.相关系数:
1
2
2
1
1
n
i
i
i
n
n
i
i
i
i
x
x
y
y
r
x
x
y
y
2.相关系数r 的性质
(1)当r>0 时,称成对样本数据正相关;当r<0 时,成对样本数据负相关;当r=0 时,
成对样本数据间没有线性相关关系.
(2)样本相关系数r 的取值范围为[-1,1].
当|r|越接近1 时,成对样本数据的线性相关程度越强;
当|r|越接近0 时,成对样本数据的线性相关程度越弱.
二.线性回归与最小二乘法
1 回归直线方程过样本点的中心
,是回归直线方程最常用的一个特征
( , )
x y
2 我们将
称为
关于
的线性回归方程,也称经验回归函数或经验回归公式,其
ˆ
ˆ
ˆ
y
bx
a
Y
x
图形称为经验回归直线.这种求经验回归方程的方法叫做最小二乘法,求得的
叫做
ˆ ˆ
,b a
b,a 的最小二乘估计,其中
1
1
2
2
2
1
1
ˆ
ˆ
ˆ
.
n
n
i
i
i
i
i
i
n
n
i
i
i
i
x
x
y
y
x y
nx y
b
x
x
x
nx
a
y
bx
3 残差的概念
对于响应变量
,通过观测得到的数据称为观测值,通过经验回归方程得到的
称为预测
Y
ˆy
值,观测值减去预测值称为残差.残差是随机误差的估计结果,通过残差的分析可以判断
模型刻画数据的效果,以及判断原始数据中是否存在可疑数据等,这方面工作称为残差分
析.
4 刻画回归效果的方式
(i)残差图法:作图时纵坐标为残差,横坐标可以选为样本编号,或身高数据,或体重估
计值等,这样作出的图形称为残差图.若残差点比较均匀地落在水平的带状区域内,带状
区域越窄,则说明拟合效果越好.
(ii)残差平方和法:残差平方和
,残差平方和越小,模型拟合效果越好,残
2
1
ˆ
n
i
i
i
y
y
差平方和越大,模型拟合效果越差.
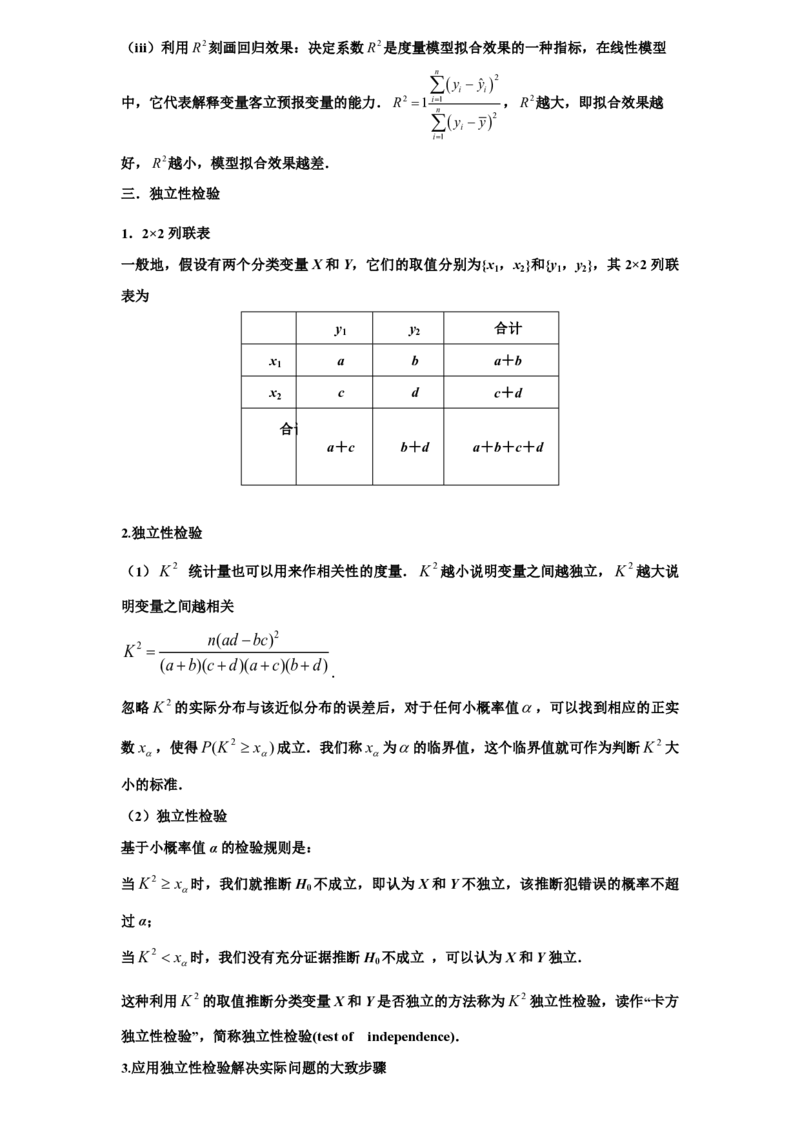
(iii)利用
刻画回归效果:决定系数
是度量模型拟合效果的一种指标,在线性模型
2
R
2
R
中,它代表解释变量客立预报变量的能力.
,
越大,即拟合效果越
2
2
1
2
1
ˆ
1
n
i
i
i
n
i
i
y
y
R
y
y
2
R
好,
越小,模型拟合效果越差.
2
R
三.独立性检验
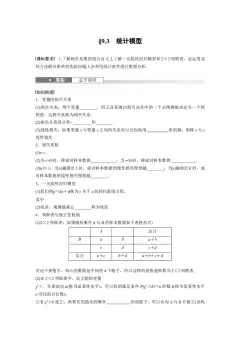
1.2×2 列联表
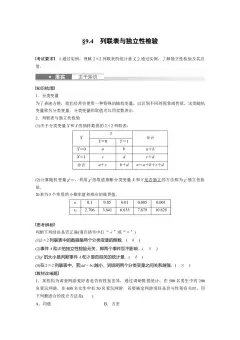
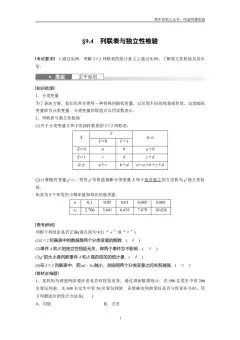
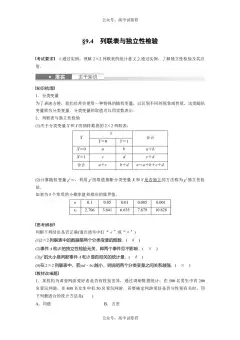
一般地,假设有两个分类变量X 和Y,它们的取值分别为{x1,x2}和{y1,y2},其2×2 列联
表为
y1
y2
合计
x1
a
b
a+b
x2
c
d
c+d
合计
a+c
b+d
a+b+c+d
2.独立性检验
(1)
统计量也可以用来作相关性的度量.
越小说明变量之间越独立,
越大说
2
K
2
K
2
K
明变量之间越相关
.
2
2
(
)
(
)(
)(
)(
)
n ad
bc
K
a
b c
d a
c b
d
忽略
的实际分布与该近似分布的误差后,对于任何小概率值
,可以找到相应的正实
2
K
数
,使得
成立.我们称
为
的临界值,这个临界值就可作为判断
大
x
)
(
2
x
K
P
x
2
K
小的标准.
(2)独立性检验
基于小概率值α 的检验规则是:
当
时,我们就推断H0 不成立,即认为X 和Y 不独立,该推断犯错误的概率不超
x
K
2
过α;
当
时,我们没有充分证据推断H0 不成立 ,可以认为X 和Y 独立.
x
K
2
这种利用
的取值推断分类变量X 和Y 是否独立的方法称为
独立性检验,读作“卡方
2
K
2
K
独立性检验”,简称独立性检验(test of independence).
3.应用独立性检验解决实际问题的大致步骤
(1)提出零假设H0:X 和Y 相互独立,并给出在问题中的解释;
(2)根据抽样数据整理出2×2 列联表,计算
的值,并与临界值
比较;
2
K
x
(3)根据检验规则得出推断结论;
(4)在X 和Y 不独立的情况下,根据需要,通过比较相应的频率,分析X 和Y 间的影响
规律.
二.典例分析
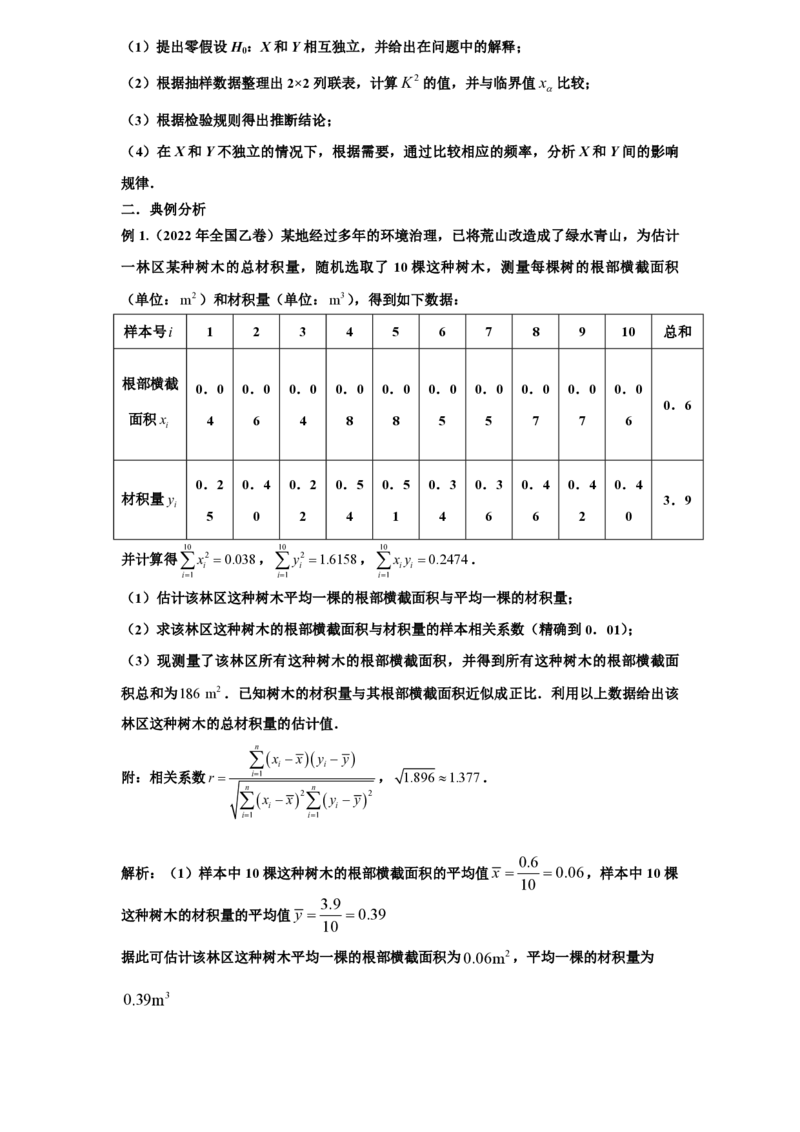
例1.(2022 年全国乙卷)某地经过多年的环境治理,已将荒山改造成了绿水青山,为估计
一林区某种树木的总材积量,随机选取了10 棵这种树木,测量每棵树的根部横截面积
(单位:
)和材积量(单位:
),得到如下数据:
2
m
3
m
样本号 i
1
2
3
4
5
6
7
8
9
10
总和
根部横截
面积
ix
0.0
4
0.0
6
0.0
4
0.0
8
0.0
8
0.0
5
0.0
5
0.0
7
0.0
7
0.0
6
0.6
材积量
iy
0.2
5
0.4
0
0.2
2
0.5
4
0.5
1
0.3
4
0.3
6
0.4
6
0.4
2
0.4
0
3.9
并计算得
,
,
.
10
2
1
0.038
i
i
x
10
2
1
1.6158
i
i
y
10
1
0.2474
i
i
i
x y
(1)估计该林区这种树木平均一棵的根部横截面积与平均一棵的材积量;
(2)求该林区这种树木的根部横截面积与材积量的样本相关系数(精确到0.01);
(3)现测量了该林区所有这种树木的根部横截面积,并得到所有这种树木的根部横截面
积总和为
.已知树木的材积量与其根部横截面积近似成正比.利用以上数据给出该
186
2
m
林区这种树木的总材积量的估计值.
附:相关系数
,
.
1
2
2
1
1
n
i
i
i
n
n
i
i
i
i
x
x
y
y
r
x
x
y
y
1.896
1.377
解析:(1)样本中10 棵这种树木的根部横截面积的平均值
,样本中10 棵
0.6
0.06
10
x
这种树木的材积量的平均值
3.9
0.39
10
y
据此可估计该林区这种树木平均一棵的根部横截面积为
,平均一棵的材积量为
2
0.06m
3
0.39m
(2)
10
10
i
i
i
i
i=1
i=1
10
10
10
10
2
2
2
2
2
2
i
i
i
i
i=1
i=1
i=1
i=1
10
10
10
x
x
y
y
x y
xy
r
x
x
y
y
x
x
y
y
2
2
(0.038 10 0.06 )(1.6158 1
0.2474 10 0.06 0.39
0.0134
0.0134
0.97
0.01377
0.000
0 0
189
9
6
.3
)
则
0.97
r
(3)设该林区这种树木的总材积量的估计值为
,又已知树木的材积量与其根部横截
3
m
Y
面积近似成正比,可得
,解之得
.则该林区这种树木的总材积量
0.06
186
=
0.39
Y
3
=1209m
Y
估计为
3
1209m
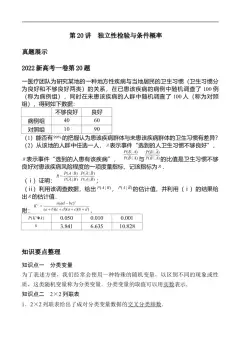
例2(2022 年新高考1 卷)一医疗团队为研究某地的一种地方性疾病与当地居民的卫生习
惯(卫生习惯分为良好和不够良好两类)的关系,在已患该疾病的病例中随机调查了100
例(称为病例组),同时在未患该疾病的人群中随机调査了100 人(称为对照组),得到如
下数据:
不够良好
良好
病例组
40
60
对照组
10
90
(1)能否有99%的把握认为患该疾病群体与未患该疾病群体的卫生习惯有差异?
附:
,
2
2
(
)
(
)(
)(
)(
)
n ad
bc
K
a
b c
d a
c b
d
解析:(1)假设患该疾病群体与未患该疾病群体的卫生习惯没有差异,
则
,所以有99%的把握认为患该疾病群体与未患
2
2
200(40
90
60 10)
24
10.828
50 150 100 100
K
该疾病群体的卫生习惯有差异.
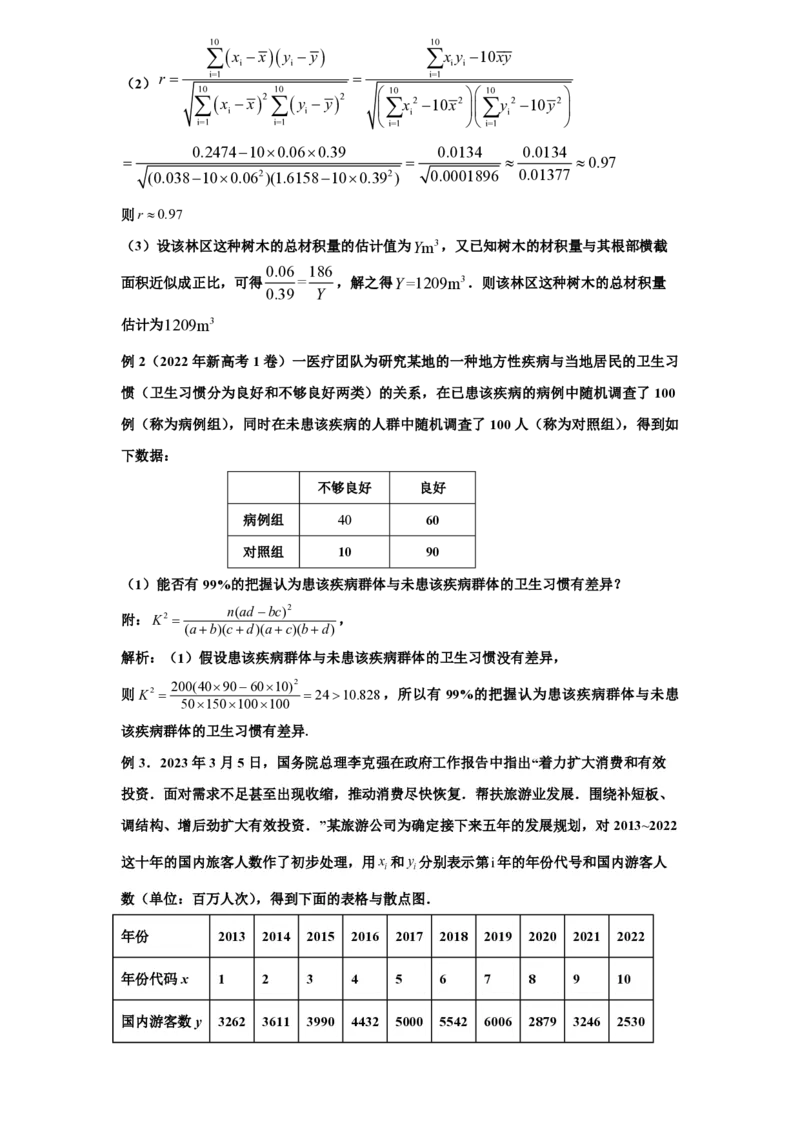
例3.2023 年3 月5 日,国务院总理李克强在政府工作报告中指出“着力扩大消费和有效
投资.面对需求不足甚至出现收缩,推动消费尽快恢复.帮扶旅游业发展.围绕补短板、
调结构、增后劲扩大有效投资.”某旅游公司为确定接下来五年的发展规划,对2013~2022
这十年的国内旅客人数作了初步处理,用
和
分别表示第年的年份代号和国内游客人
ix
iy
i
数(单位:百万人次),得到下面的表格与散点图.
年份
2013
2014
2015
2016
2017
2018
2019
2020
2021
2022
年份代码x
1
2
3
4
5
6
7
8
9
10
国内游客数y
3262
3611
3990
4432
5000
5542
6006
2879
3246
2530
(1)2020 年~2022 年疫情特殊时期,旅游业受到重挫,现剔除这三年的数据,再根据剩
余样本数据
(
,2,3,…,7)建立国内游客人数
关于年份代号
的一元线性
,
i
i
x y
1
i
y
x
回归模型;
(2)2023 年春节期间旅游市场繁荣火爆,预计2023 年国内旅游人数约4550 百万人次,
假若2024 年∼2027 年能延续2013 年∼2019 年的增长势头,请结合以上信息预测2027 年国
内游客人数.
附:回归直线的斜率和截距的最小二乘估计公式分别为:
,
1
2
1
ˆ
n
i
i
i
n
i
i
x
x
y
y
b
x
x
ˆ
a
y
bx
参考数据:
,
7
1
31843
i
i
y
7
1
4
4549
13104
i
i
i
x
y
解析:(1)由题可得
,
1 (1
2
3
4
5
6
7)
4
7
x
,
7
2
1
4
9
4 1 0 1
4
9
28
i
i
x
,所以
,
7
1
1
454
31843
7
9
7
i
i
y
y
7
1
7
2
1
4
4549
13104
ˆ
468
28
4
i
i
i
i
i
x
y
b
x
,
4549
468 4
2677
a
所以根据样本数据
(
,2,3,…,7)建立一元线性回归模型为
,
i
i
x y
1
i
468
2677
y
x
;
(2)由
可知,年份每增加1 年国内旅游人数将增加468 百万人次,
468
2677
y
x
所以预测2027 年国内游客人数为
百万人次.
468 4
4550
6422
三.习题演练
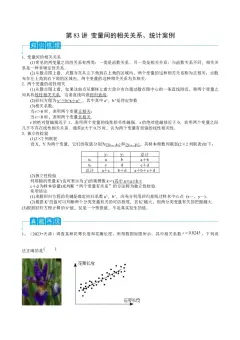
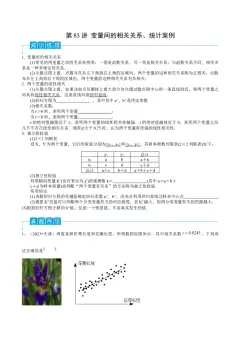
1.某兴趣小组研究光照时长x(h)和向日葵种子发芽数量y(颗)之间的关系,采集5
组数据,作如图所示的散点图.若去掉
后,下列说法正确的是( )
10,2
D
A.相关系数r 变小
B.决定系数
变小
2
R
C.残差平方和变大
D.解释变量x 与预报变量y 的相关性变强
解析:从图中可以看出
较其他点,偏离直线远,故去掉
后,回归效果更
10,2
D
10,2
D
好,
对于A,相关系数
越接近于1,模型的拟合效果越好,若去掉
后,相关系数r
r
10,2
D
变大,故A 错误;
对于B,决定系数
越接近于1,模型的拟合效果越好,若去掉
后,决定系数
2
R
10,2
D
2
R
变大,故B 错误;
对于C,残差平方和越小,模型的拟合效果越好,若去掉
后,残差平方和变小,
10,2
D
故C 错误;
对于D,若去掉
后,解释变量x 与预报变量y 的相关性变强,且是正相关,故D
10,2
D
正确.故选:D.
2.为了研究y 关于x 的线性相关关系,收集了5 组样本数据(见下表):
x
1
2
3
4
5
y
0.5
0.8
1
1.2
1.5
假设经验回归方程为
,则( )
ˆ
ˆ
0.28
y
bx
A.
ˆ
0.24
b
B.当
时,y 的预测值为2.2
8
x
C.样本数据y 的40%分位数为0.8
D.去掉样本点
后,x 与y 的样本相关系数r 不变
3,1
解析:对于A 选项:线性回归方程
必过点
,
,
,解得
ˆ
ˆ
0.28
y
bx
,x y
3
x
1
y
ˆ
0.24
b
,所以选项A 正确;
对于B 选项:当
时,
可以的出y 的预测值为2.2,所以B 选项正确;
8
x
ˆ
0.24
0.28
y
x
对于C 选项:从小到大排列共有5 个数据,则
是整数,则第40 百分位数为
5 40%
2
i
从小到大排列的第3 个数据,
即第40 百分位数为3,所以C 选项错误;
对于D 选项:因为相关系数为
,
1
2
2
1
1
n
i
i
i
n
n
i
i
i
i
x
x
y
y
r
x
x
y
y
5 组样本数据的相关系数为:
,
5
1
5
5
2
2
2
2
2
2
2
1
1
2
0.5
1
0.2
0 0 1 0.2
2 0.5
4 1 0 1
4
0.5
0.2
0
0.2
0.5
i
i
i
i
i
i
i
x
x
y
y
r
x
x
y
y
去掉样本中心点
后相关系数为
3,1
,
4
1
4
4
2
2
2
2
2
2
1
1
2
0.5
1
0.2
1 0.2
2 0.5
4 1 1
4
0.5
0.2
0.2
0.5
i
i
i
i
i
i
i
x
x
y
y
r
x
x
y
y
所以相关系数r 不变,所以D 选项正确;故选:ABD.
3.随着科技发展的日新月异,人工智能融入了各个行业,促进了社会的快速发展.其中利
用人工智能生成的虚拟角色因为拥有更低的人工成本,正逐步取代传统的真人直播带
货.某公司使用虚拟角色直播带货销售金额得到逐步提升,以下为该公司自2023 年8 月
使用虚拟角色直播带货后的销售金额情况统计.
年月
2023 年8
月
2023 年9
月
2023 年10
月
2023 年11
月
2023 年12
月
2024 年1
月
月份编号
x
1
2
3
4
5
6
销售金额y
/万元
15.4
25.4
35.4
85.4
155.4
195.4
若
与
的相关关系拟用线性回归模型表示,回答如下问题:
y
x
(1)试求变量
与
的样本相关系数(结果精确到0.01);
y
x
r
(2)试求
关于
的经验回归方程,并据此预测2024 年2 月份该公司的销售金额.
y
x
附:经验回归方程
,其中
,
,
ˆ
ˆ
ˆ
y
bx
a
1
1
2
2
2
1
1
ˆ
n
n
i
i
i
i
i
i
n
n
i
i
i
i
x
x
y
y
x y
nxy
b
x
x
x
nx
ˆ
ˆa
y
bx
样本相关系数
;
1
1
2
2
2
2
2
2
1
1
1
1
n
n
i
i
i
i
i
i
n
n
n
n
i
i
i
i
i
i
i
i
x
x
y
y
x y
nxy
r
x
x
y
y
x
nx
y
ny
参考数据:
,
.
6
1
2463.4
i
i
i
x y
6
2
1
20 70
i
i
y
y
解析:(1)
,
1
2
3
4
5
6
7
15.4
25.4
35.4
85.4 155.4 195.4
,
85.4
6
2
6
x
y
,
6
2
2
1
49
6
1
4
9 16
25
36
6
17.5
4
i
i
x
x
所以
.
1
2
2
2
2
1
1
6
6
6
7
6
2463.4
6
85.4
670
2
0.96
20 35
17.5
20 70
6
6
i
i
i
i
i
i
i
x y
xy
r
x
x
y
y
(2)由题意
,
1
2
2
1
6
6
7
6
2463.4
6
85.4
2
ˆ
38.3
17.5
6
i
i
i
i
i
x y
xy
b
x
x
所以
,
7
85.4
38.3
48.7
2
a
所以
关于
的经验回归方程为
,
y
x
38.3
48.7
y
x
所以预测2024 年2 月份该公司的销售金额为
万元.
38.3 7
48.7
219.4
y