2026 年高考数学·教考衔接
教材命题点探源
-----------------------------供2026 高考备考二轮、三轮复习及考前使用-------------------------
教考衔接十二  统计与成对数据的统计分析
--------------■高考命题·解读■-----------------
核心考点
五年考情
考点1.众数、中位数、平均数
及方差的计算
2025·全国二卷  2023·新课标Ⅰ卷   2023·全国乙卷

2021·新高考全国Ⅰ卷   2021·新高考全国Ⅱ卷
2021·全国乙卷
考点2.独立性检验
2025·全国一卷   2024·全国甲卷  2023·全国甲卷
2022·全国甲卷   2022·新高考全国Ⅰ卷
🎯【命题解读】(考前必看)
统计与成对数据的统计分析作为高考的必考内容,预计以“一小一大”的格局呈现.
(1)小题一般比较简单,出现在选择题或填空题中比较靠前的位置,命题角度主要有:统计数据的分析,
多以统计图表(折线图或柱状图)的形式提供数据,进行数据的特征分析,如均值、方差、最值点及趋势分析等.
(2)解答题属于中档以上题目,题目涉及两个以上的知识模块,具有一定的综合性.命题角度主要有三个
方面:一是统计图表与分布列的综合;二是统计数据的数字特征与回归分析、独立性检验等的综合,注重数据
的分析与应用;三是统计图表与函数内容的结合,包括函数解析式的求解与应用等,这有可能重新成为命题的
热点.
🎯练教材-----必刷经典母题
【教材母题1】 (人教A 版必修第二册P180·T1)为了合理调配电力资源,某市欲了解全市50 000 户居民的日用
电量.若通过简单随机抽样从中抽取了300 户进行调查,得到其日用电量的平均数为5.5 kW·h,则可以推测全市
居民用户日用电量的平均数(  )
A.一定为5.5 kW·h
B.高于5.5 kW·h       C.低于5.5 kW·h
D.约为5.5 kW·h
【答案】D
【解析】由样本的数字特征与总体的数字特征的关系,可知全市居民用户日用电量的平均数约为5.5 kW·h.
【教材母题2】(人教A 版必修第二册P184·T1)数据x1,x2,…,xm的平均数为x,数据y1,y2,…,yn的平均数
为y,证明:=x +y.
【证明】∵∑xi=x1+x2+x3+…+xm=mx,∑yi=y1+y2+y3+…+yn=ny,
∴==x+y.
【教材母题3】(人教A 版必修第二册P188·T6)数据x1,x2,…,xn的平均数为x,数据y1,y2,…,yn的平均数
为y,a,b 为常数.如果满足y1=ax1+b,y2=ax2+b,…,yn=axn+b.证明:y=ax+b.
【证明】∵=x,=y,∴x1+x2+…+xn=nx,y1+y2+…+yn=ny.
∵y1=ax1+b,y2=ax2+b,…,yn=axn+b,∴y1+y2+…+yn=a(x1+x2+…+xn)+nb,
∴ny=a·nx+nb,∴y=ax+b.
【教材母题4】(人教A 版必修第二册P224·T2)四名同学各掷骰子5 次,分别记录每次骰子出现的点数,根据四
名同学的统计结果,可以判断出一定没有出现点数6 的是(  )
A.平均数为3,中位数为2
B.中位数为3,众数为2
C.平均数为2,方差为2.4
D.中位数为3,方差为2.8
【答案】C
【解析】对于A,当投掷骰子出现结果为1,1,2,5,6 时,满足平均数为3,中位数为2,可以出现点数6,故A 错误;
对于B,当投掷骰子出现结果为2,2,3,4,6 时,满足中位数为3,众数为2,可以出现点数6,故B 错误;
对于C,若平均数为2,且出现6 点,则方差s2>1
5(6-2)2=3.2>2.4,
∴平均数为2,方差为2.4 时,一定没有出现点数6,故C 正确;
对于D,当投掷骰子出现结果为1,2,3,3,6 时,满足中位数为3,
平均数为x=1
5(1+2+3+3+6)=3,
方差为s2=1
5[(1-3)2+(2-3)2+(3-3)2+(3-3)2+(6-3)2]=2.8,可以出现点数6,故D 错误.
【教材母题5】 (人教A 版必修第二册P215·T2)数据x1,x2,…,xn的方差为sx
2,数据y1,y2,…,yn的方差为s y
2,a,b 为常
数.证明:
(1)如果y1=x1+b,y2=x2+b,…,yn=xn+b,那么s y
2=sx
2;
(2)如果y1=ax1,y2=ax2,…,yn=axn,那么s y
2=a2sx
2.
【证明】(1)∵y=1
n(y1+y2+…+yn)=1
n[(x1+b)+(x2+b)+…+(xn+b)]=1
n[(x1+x2+…+xn)+nb]=1
n(x1+x2+…+xn)+b=x+b,
∴s y
2=1
n[(y1-y)2+(y2-y)2+…+(yn-y)2]=1
n[(x1-x)2+(x2-x)2+…+(xn-x)2]=sx
2.
(2)∵y=1
n(y1+y2+…+yn)=1
n(ax1+ax2+…+axn)=a·1
n(x1+x2+…+xn)=ax,
∴s y
2=1
n[(y1-y)2+(y2-y)2+…+(yn-y)2]=1
n[(ax1-ax)2+(ax2-ax)2+…+(axn-ax)2]=a2·1
n[(x1-x)2+(x2-x)2+…+(xn-x)2]=a2sx
2.
【🚀衔接高考】
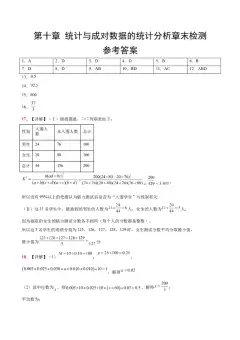
(1)(2025·全国二卷)样本数据2,8,14,16,20 的平均数为(      )
A.8
B.9
C.12
D.18
【答案】C
【解析】样本数据
的平均数为
.故选C.
(2)(多选)(2021·新高考Ⅰ卷)有一组样本数据x1,x2,…,xn,由这组数据得到新样本数据y1,y2,…,yn,其中
yi=xi+c(i=1,2,…,n),c 为非零常数,则(  )
A.两组样本数据的样本平均数相同          B.两组样本数据的样本中位数相同
C.两组样本数据的样本标准差相同          D.两组样本数据的样本极差相同
【答案】CD
【解析】设样本数据x1,x2,…,xn的平均数、中位数、标准差、极差分别为x,m,σ,t,依题意得,新样本数据y1,y2,…,yn
的平均数、中位数、标准差、极差分别为x+c,m+c,σ,t,因为c≠0,所以A,B 不正确,C,D 正确,故选CD.
(3)(多选)(2023·新高考Ⅰ卷)有一组样本数据x1,x2,…,x6,其中x1是最小值,x6是最大值,则(  )
A.x2,x3,x4,x5的平均数等于x1,x2,…,x6的平均数       B.x2,x3,x4,x5的中位数等于x1,x2,…,x6的中位数
C.x2,x3,x4,x5的标准差不小于x1,x2,…,x6的标准差    D.x2,x3,x4,x5的极差不大于x1,x2,…,x6的极差
【答案】BD
【解析】取x1=1,x2=x3=x4=x5=2,x6=9,则x2,x3,x4,x5的平均数等于2,标准差为0,x1,x2,…,x6的平均数等于3,
标准差为❑√
22
3 =
❑√66
3
,故A,C 均不正确;根据中位数的定义,将x1,x2,…,x6按从小到大的顺序进行排列,中位数是中间
两个数的算术平均数,由于x1是最小值,x6是最大值,故x2,x3,x4,x5的中位数是将x2,x3,x4,x5按从小到大的顺序排列后中
间两个数的算术平均数,与x1,x2,…,x6的中位数相等,故B 正确;
根据极差的定义,知x2,x3,x4,x5的极差不大于x1,x2,…,x6的极差,故D 正确.综上,选BD.
(4)(2020·全国Ⅲ卷)设一组样本数据x1,x2,…,xn的方差为0.01,则数据10x1,10x2,…,10xn的方差为(  )
A.0.01              B.0.1
C.1                D.10
【答案】C
【解析】10x1,10x2,…,10xn的方差为102×0.01=1.故选C.
【教材母题6】 (人教A 版必修第二册P216T2)甲、乙两台机床同时生产一种零件,在10 天中,两台机床每天生
产的次品数分别为:
甲 0 1 0 2 2 0 3 1 2 4
乙 2 3 1 1 0 2 1 1 0 1
分别计算这两组数据的平均数和标准差,从计算结果看,哪台机床的性能更好?
【解析】甲机床的平均数x甲=0+1+0+…+ 4
10
=1.5,标准差s 甲=❑√
1
10 [(0-1.5)
2+(1-1.5)
2+…+(4 -1.5)
2]
≈1.28;
乙机床的平均数y乙=2+3+…+1
10
=1.2,标准差s 乙=❑√
1
10 [(2-1.2)
2+(3-1.2)
2+…+(1-1.2)
2]≈0.87.
比较发现乙机床的平均数较小而且标准差也较小,说明乙机床生产的次品数比甲机床生产的次品数少,而且更为稳
定,所以乙机床的性能较好.
【🚀衔接高考】
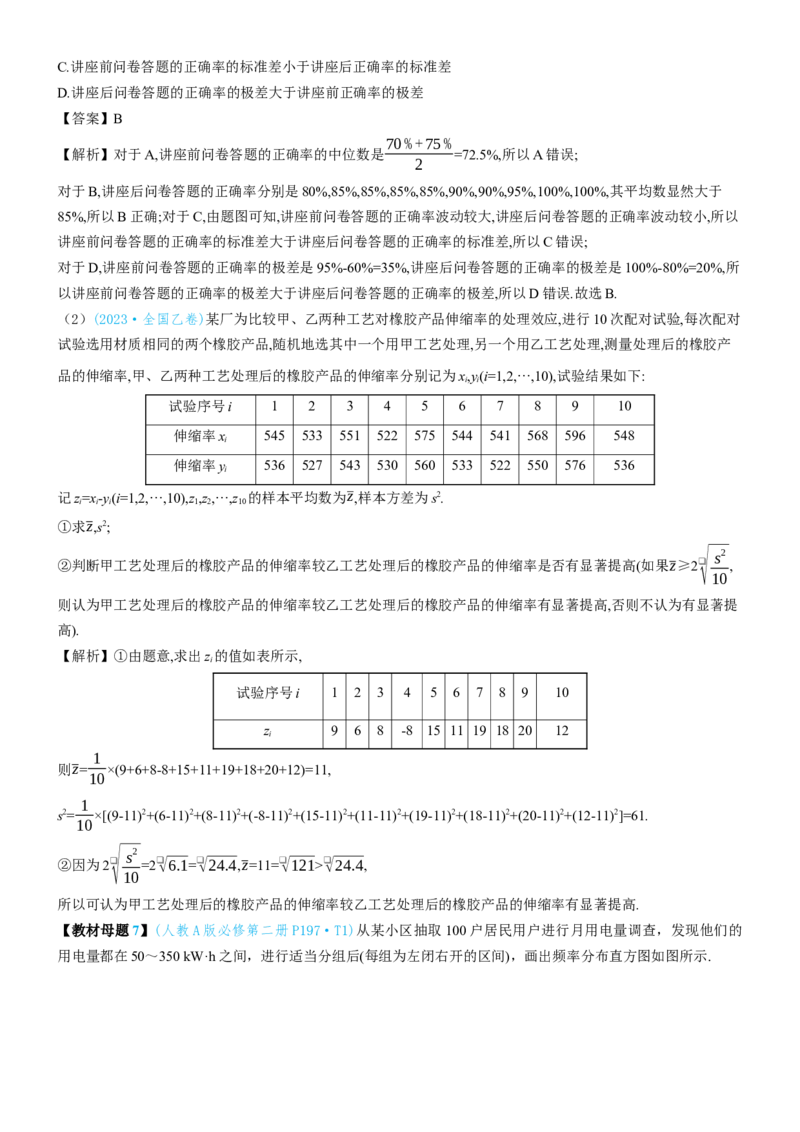
(1)(2022·全国甲卷)某社区通过公益讲座以普及社区居民的垃圾分类知识.为了解讲座效果,随机抽取10 位社
区居民,让他们在讲座前和讲座后各回答一份垃圾分类知识问卷,这10 位社区居民在讲座前和讲座后问卷答题的
正确率如图,则(  )
A.讲座前问卷答题的正确率的中位数小于70%
B.讲座后问卷答题的正确率的平均数大于85%
C.讲座前问卷答题的正确率的标准差小于讲座后正确率的标准差
D.讲座后问卷答题的正确率的极差大于讲座前正确率的极差
【答案】B
【解析】对于A,讲座前问卷答题的正确率的中位数是70 %+75 %
2
=72.5%,所以A 错误;
对于B,讲座后问卷答题的正确率分别是80%,85%,85%,85%,85%,90%,90%,95%,100%,100%,其平均数显然大于
85%,所以B 正确;对于C,由题图可知,讲座前问卷答题的正确率波动较大,讲座后问卷答题的正确率波动较小,所以
讲座前问卷答题的正确率的标准差大于讲座后问卷答题的正确率的标准差,所以C 错误;
对于D,讲座前问卷答题的正确率的极差是95%-60%=35%,讲座后问卷答题的正确率的极差是100%-80%=20%,所
以讲座前问卷答题的正确率的极差大于讲座后问卷答题的正确率的极差,所以D 错误.故选B.
(2)(2023·全国乙卷)某厂为比较甲、乙两种工艺对橡胶产品伸缩率的处理效应,进行10 次配对试验,每次配对
试验选用材质相同的两个橡胶产品,随机地选其中一个用甲工艺处理,另一个用乙工艺处理,测量处理后的橡胶产
品的伸缩率,甲、乙两种工艺处理后的橡胶产品的伸缩率分别记为xi,yi(i=1,2,…,10),试验结果如下:
试验序号i
1
2
3
4
5
6
7
8
9
10
伸缩率xi
545
533
551
522
575
544
541
568
596
548
伸缩率yi
536
527
543
530
560
533
522
550
576
536
记zi=xi-yi(i=1,2,…,10),z1,z2,…,z10的样本平均数为z,样本方差为s2.
①求z,s2;
②判断甲工艺处理后的橡胶产品的伸缩率较乙工艺处理后的橡胶产品的伸缩率是否有显著提高(如果z≥2❑√
s
2
10
,
则认为甲工艺处理后的橡胶产品的伸缩率较乙工艺处理后的橡胶产品的伸缩率有显著提高,否则不认为有显著提
高).
【解析】①由题意,求出zi的值如表所示,
试验序号i
1
2
3
4
5
6
7
8
9
10
zi
9
6
8
-8
15 11 19 18 20
12
则z= 1
10×(9+6+8-8+15+11+19+18+20+12)=11,
s2= 1
10×[(9-11)2+(6-11)2+(8-11)2+(-8-11)2+(15-11)2+(11-11)2+(19-11)2+(18-11)2+(20-11)2+(12-11)2]=61.
②因为2❑√
s
2
10
=2❑√6.1=❑√24.4,z=11=❑√121>❑√24.4,
所以可认为甲工艺处理后的橡胶产品的伸缩率较乙工艺处理后的橡胶产品的伸缩率有显著提高.
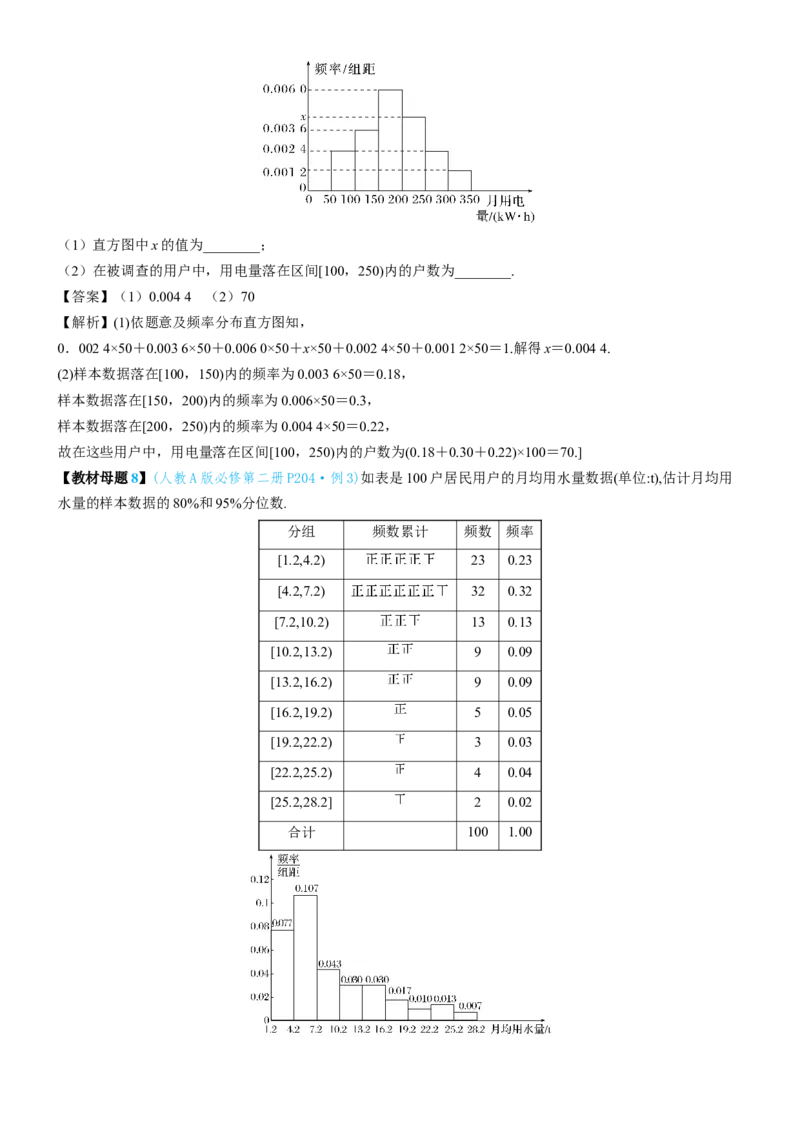
【教材母题7】(人教A 版必修第二册P197·T1)从某小区抽取100 户居民用户进行月用电量调查,发现他们的
用电量都在50~350 kW·h 之间,进行适当分组后(每组为左闭右开的区间),画出频率分布直方图如图所示.
(1)直方图中x 的值为________;
(2)在被调查的用户中,用电量落在区间[100,250)内的户数为________.
【答案】(1)0.004 4 (2)70
【解析】(1)依题意及频率分布直方图知,
0.002 4×50+0.003 6×50+0.006 0×50+x×50+0.002 4×50+0.001 2×50=1.解得x=0.004 4.
(2)样本数据落在[100,150)内的频率为0.003 6×50=0.18,
样本数据落在[150,200)内的频率为0.006×50=0.3,
样本数据落在[200,250)内的频率为0.004 4×50=0.22,
故在这些用户中,用电量落在区间[100,250)内的户数为(0.18+0.30+0.22)×100=70.]
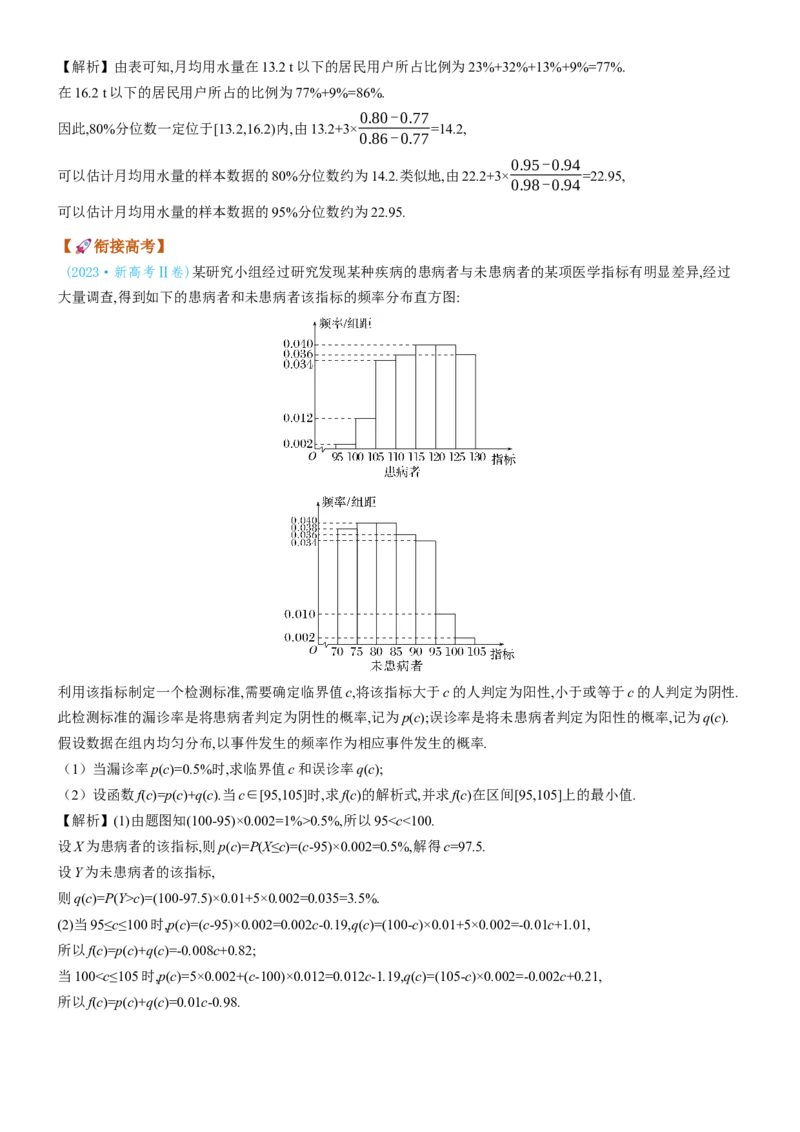
【教材母题8】(人教A 版必修第二册P204·例3)如表是100 户居民用户的月均用水量数据(单位:t),估计月均用
水量的样本数据的80%和95%分位数.
分组
频数累计
频数
频率
[1.2,4.2)
23
0.23
[4.2,7.2)
32
0.32
[7.2,10.2)
13
0.13
[10.2,13.2)
9
0.09
[13.2,16.2)
9
0.09
[16.2,19.2)
5
0.05
[19.2,22.2)
3
0.03
[22.2,25.2)
4
0.04
[25.2,28.2]
2
0.02
合计
100
1.00
【解析】由表可知,月均用水量在13.2 t 以下的居民用户所占比例为23%+32%+13%+9%=77%.
在16.2 t 以下的居民用户所占的比例为77%+9%=86%.
因此,80%分位数一定位于[13.2,16.2)内,由13.2+3×0.80-0.77
0.86-0.77 =14.2,
可以估计月均用水量的样本数据的80%分位数约为14.2.类似地,由22.2+3×0.95-0.94
0.98-0.94 =22.95,
可以估计月均用水量的样本数据的95%分位数约为22.95.
【🚀衔接高考】
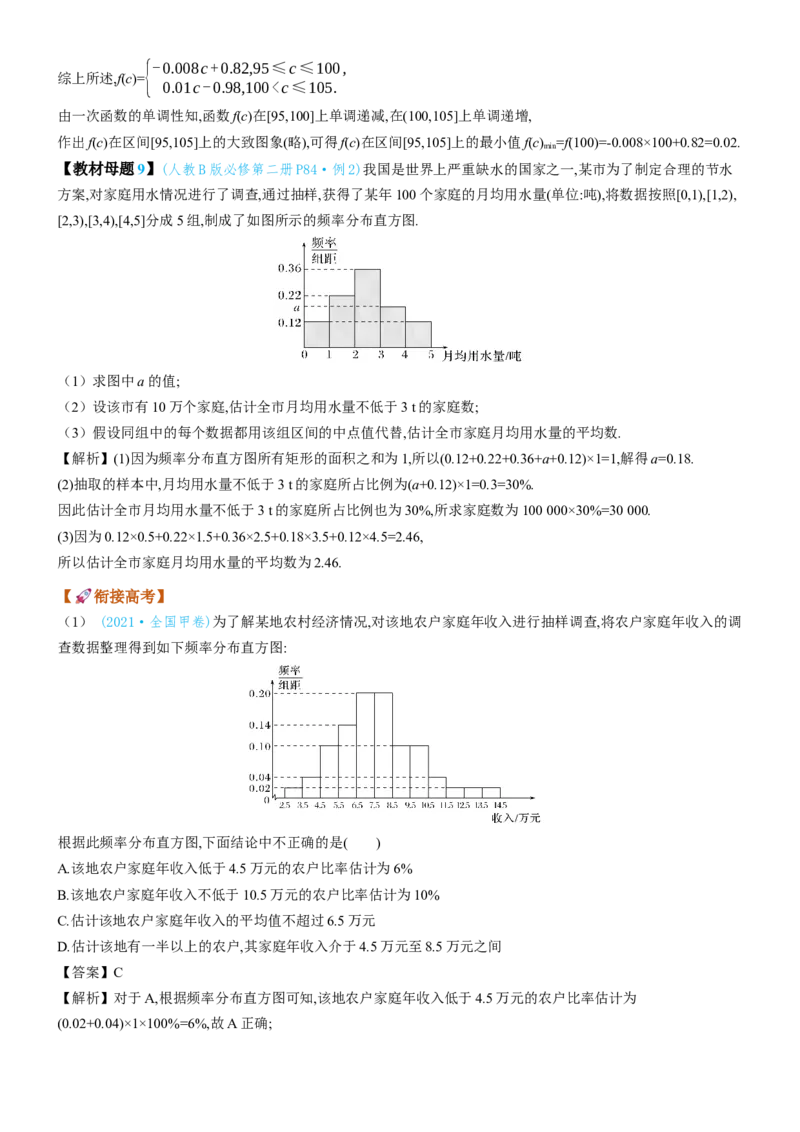
 (2023·新高考Ⅱ卷)某研究小组经过研究发现某种疾病的患病者与未患病者的某项医学指标有明显差异,经过
大量调查,得到如下的患病者和未患病者该指标的频率分布直方图:
利用该指标制定一个检测标准,需要确定临界值c,将该指标大于c 的人判定为阳性,小于或等于c 的人判定为阴性.
此检测标准的漏诊率是将患病者判定为阴性的概率,记为p(c);误诊率是将未患病者判定为阳性的概率,记为q(c).
假设数据在组内均匀分布,以事件发生的频率作为相应事件发生的概率.
(1)当漏诊率p(c)=0.5%时,求临界值c 和误诊率q(c);
(2)设函数f(c)=p(c)+q(c).当c∈[95,105]时,求f(c)的解析式,并求f(c)在区间[95,105]上的最小值.
【解析】(1)由题图知(100-95)×0.002=1%>0.5%,所以95<c<100.
设X 为患病者的该指标,则p(c)=P(X≤c)=(c-95)×0.002=0.5%,解得c=97.5.
设Y 为未患病者的该指标,
则q(c)=P(Y>c)=(100-97.5)×0.01+5×0.002=0.035=3.5%.
(2)当95≤c≤100 时,p(c)=(c-95)×0.002=0.002c-0.19,q(c)=(100-c)×0.01+5×0.002=-0.01c+1.01,
所以f(c)=p(c)+q(c)=-0.008c+0.82;
当100<c≤105 时,p(c)=5×0.002+(c-100)×0.012=0.012c-1.19,q(c)=(105-c)×0.002=-0.002c+0.21,
所以f(c)=p(c)+q(c)=0.01c-0.98.
综上所述,f(c)={
-0.008c +0.82,95≤c≤100,
0.01c -0.98,100<c≤105.
由一次函数的单调性知,函数f(c)在[95,100]上单调递减,在(100,105]上单调递增,
作出f(c)在区间[95,105]上的大致图象(略),可得f(c)在区间[95,105]上的最小值f(c)min=f(100)=-0.008×100+0.82=0.02.
【教材母题9】(人教B 版必修第二册P84·例2)我国是世界上严重缺水的国家之一,某市为了制定合理的节水
方案,对家庭用水情况进行了调查,通过抽样,获得了某年100 个家庭的月均用水量(单位:吨),将数据按照[0,1),[1,2),
[2,3),[3,4),[4,5]分成5 组,制成了如图所示的频率分布直方图.
(1)求图中a 的值;
(2)设该市有10 万个家庭,估计全市月均用水量不低于3 t 的家庭数;
(3)假设同组中的每个数据都用该组区间的中点值代替,估计全市家庭月均用水量的平均数.
【解析】(1)因为频率分布直方图所有矩形的面积之和为1,所以(0.12+0.22+0.36+a+0.12)×1=1,解得a=0.18.
(2)抽取的样本中,月均用水量不低于3 t 的家庭所占比例为(a+0.12)×1=0.3=30%.
因此估计全市月均用水量不低于3 t 的家庭所占比例也为30%,所求家庭数为100 000×30%=30 000.
(3)因为0.12×0.5+0.22×1.5+0.36×2.5+0.18×3.5+0.12×4.5=2.46,
所以估计全市家庭月均用水量的平均数为2.46.
【🚀衔接高考】
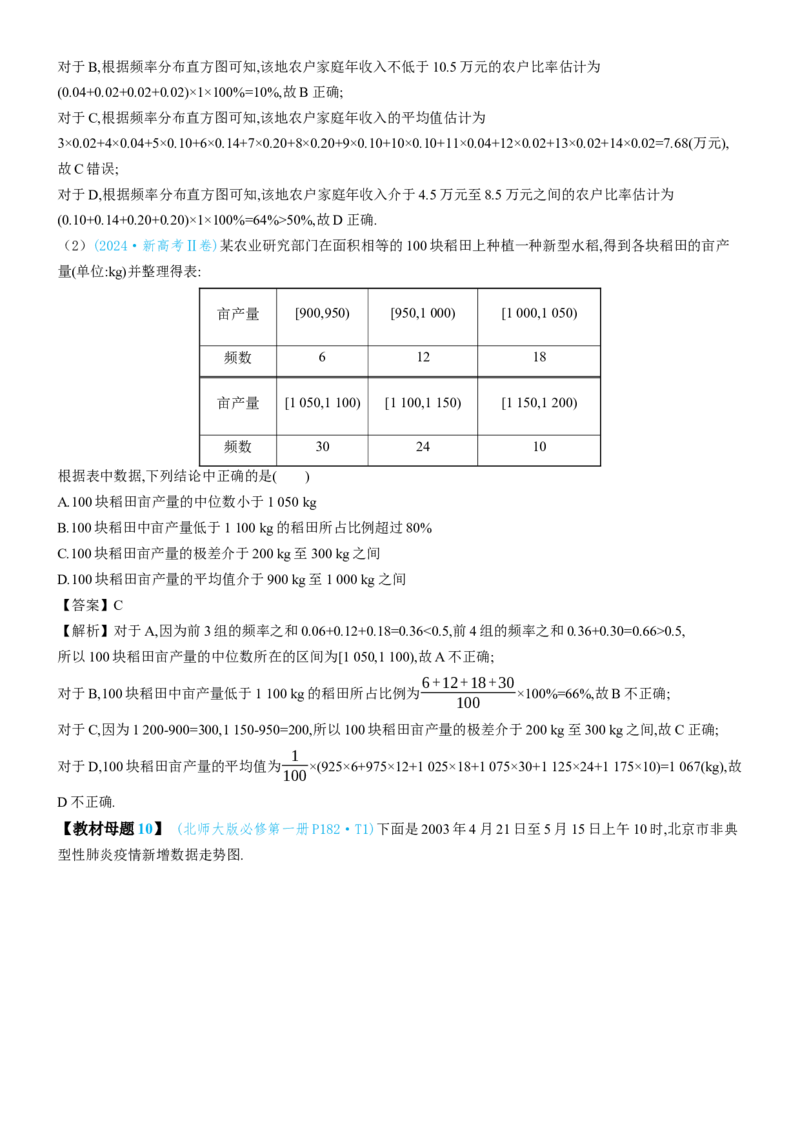
(1) (2021·全国甲卷)为了解某地农村经济情况,对该地农户家庭年收入进行抽样调查,将农户家庭年收入的调
查数据整理得到如下频率分布直方图:
根据此频率分布直方图,下面结论中不正确的是(  )
A.该地农户家庭年收入低于4.5 万元的农户比率估计为6%
B.该地农户家庭年收入不低于10.5 万元的农户比率估计为10%
C.估计该地农户家庭年收入的平均值不超过6.5 万元
D.估计该地有一半以上的农户,其家庭年收入介于4.5 万元至8.5 万元之间
【答案】C
【解析】对于A,根据频率分布直方图可知,该地农户家庭年收入低于4.5 万元的农户比率估计为
(0.02+0.04)×1×100%=6%,故A 正确;
对于B,根据频率分布直方图可知,该地农户家庭年收入不低于10.5 万元的农户比率估计为
(0.04+0.02+0.02+0.02)×1×100%=10%,故B 正确;
对于C,根据频率分布直方图可知,该地农户家庭年收入的平均值估计为
3×0.02+4×0.04+5×0.10+6×0.14+7×0.20+8×0.20+9×0.10+10×0.10+11×0.04+12×0.02+13×0.02+14×0.02=7.68(万元),
故C 错误;
对于D,根据频率分布直方图可知,该地农户家庭年收入介于4.5 万元至8.5 万元之间的农户比率估计为
(0.10+0.14+0.20+0.20)×1×100%=64%>50%,故D 正确.
(2)(2024·新高考Ⅱ卷)某农业研究部门在面积相等的100 块稻田上种植一种新型水稻,得到各块稻田的亩产
量(单位:kg)并整理得表:
亩产量
[900,950)
[950,1 000)
[1 000,1 050)
频数
6
12
18
亩产量
[1 050,1 100)
[1 100,1 150)
[1 150,1 200)
频数
30
24
10
根据表中数据,下列结论中正确的是(  )
A.100 块稻田亩产量的中位数小于1 050 kg
B.100 块稻田中亩产量低于1 100 kg 的稻田所占比例超过80%
C.100 块稻田亩产量的极差介于200 kg 至300 kg 之间
D.100 块稻田亩产量的平均值介于900 kg 至1 000 kg 之间
【答案】C
【解析】对于A,因为前3 组的频率之和0.06+0.12+0.18=0.36<0.5,前4 组的频率之和0.36+0.30=0.66>0.5,
所以100 块稻田亩产量的中位数所在的区间为[1 050,1 100),故A 不正确;
对于B,100 块稻田中亩产量低于1 100 kg 的稻田所占比例为6+12+18+30
100
×100%=66%,故B 不正确;
对于C,因为1 200-900=300,1 150-950=200,所以100 块稻田亩产量的极差介于200 kg 至300 kg 之间,故C 正确;
对于D,100 块稻田亩产量的平均值为1
100×(925×6+975×12+1 025×18+1 075×30+1 125×24+1 175×10)=1 067(kg),故
D 不正确.
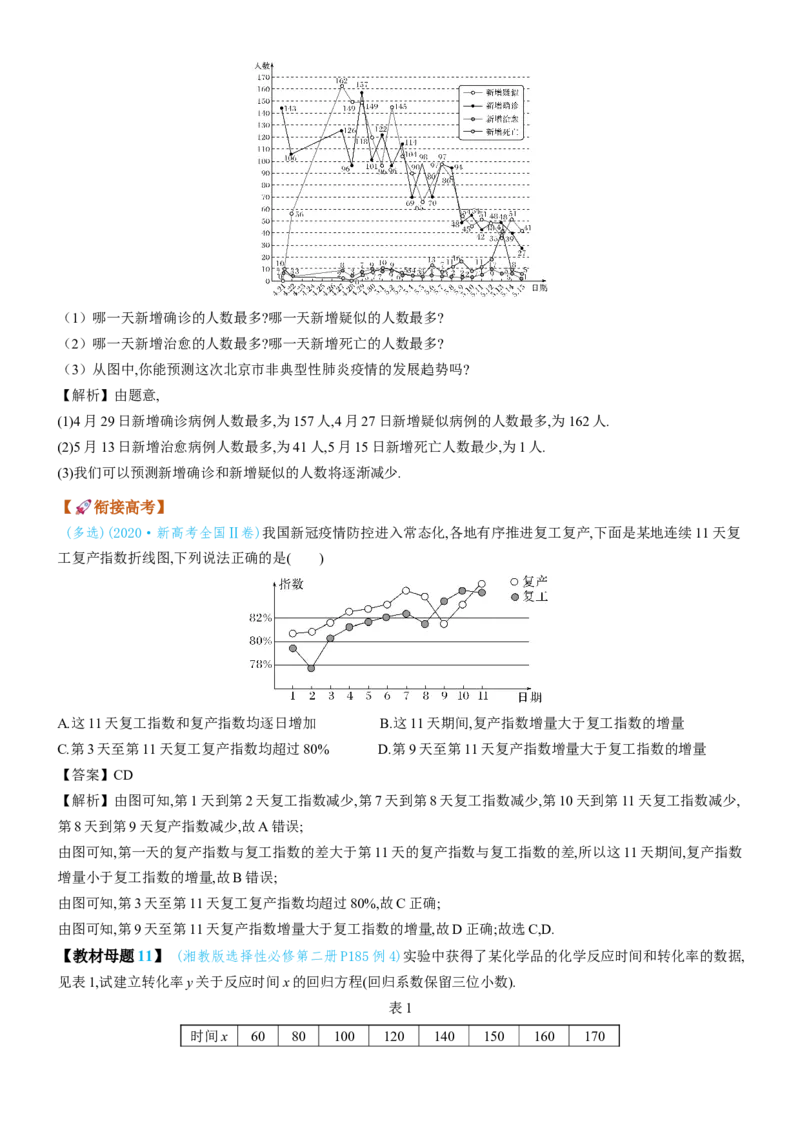
【教材母题10】 (北师大版必修第一册P182·T1)下面是2003 年4 月21 日至5 月15 日上午10 时,北京市非典
型性肺炎疫情新增数据走势图.
(1)哪一天新增确诊的人数最多?哪一天新增疑似的人数最多?
(2)哪一天新增治愈的人数最多?哪一天新增死亡的人数最多?
(3)从图中,你能预测这次北京市非典型性肺炎疫情的发展趋势吗?
【解析】由题意,
(1)4 月29 日新增确诊病例人数最多,为157 人,4 月27 日新增疑似病例的人数最多,为162 人.
(2)5 月13 日新增治愈病例人数最多,为41 人,5 月15 日新增死亡人数最少,为1 人.
(3)我们可以预测新增确诊和新增疑似的人数将逐渐减少.
【🚀衔接高考】
 (多选)(2020·新高考全国Ⅱ卷)我国新冠疫情防控进入常态化,各地有序推进复工复产,下面是某地连续11 天复
工复产指数折线图,下列说法正确的是(  )
A.这11 天复工指数和复产指数均逐日增加         B.这11 天期间,复产指数增量大于复工指数的增量
C.第3 天至第11 天复工复产指数均超过80%       D.第9 天至第11 天复产指数增量大于复工指数的增量
【答案】CD
【解析】由图可知,第1 天到第2 天复工指数减少,第7 天到第8 天复工指数减少,第10 天到第11 天复工指数减少,
第8 天到第9 天复产指数减少,故A 错误;
由图可知,第一天的复产指数与复工指数的差大于第11 天的复产指数与复工指数的差,所以这11 天期间,复产指数
增量小于复工指数的增量,故B 错误;
由图可知,第3 天至第11 天复工复产指数均超过80%,故C 正确;
由图可知,第9 天至第11 天复产指数增量大于复工指数的增量,故D 正确;故选C,D.
【教材母题11】 (湘教版选择性必修第二册P185 例4)实验中获得了某化学品的化学反应时间和转化率的数据,
见表1,试建立转化率y 关于反应时间x 的回归方程(回归系数保留三位小数).
表1
时间x
60
80
100
120
140
150
160
170
/min
转化率
y/%
6.13
9.99
15.02
20.92
31.11
38.85
47.25
55.05
【解析】根据收集的数据作散点图(图1)
观察散点图可知,样本点并没有分布在某条直线附近,因而变量y 与x 之间没有明显的线性相关关系,所以不能直接
利用线性回归模型来刻画这两个变量之间的关系.根据已有的数学知识,可以认为样本点分布在指数型曲线y=c1
e
c2 x的附近,其中c1和c2是待定参数.为估计参数c1和c2,在y=c1e
c2 x的两端取对数,得到ln y=ln c1+c2x.
再令z=ln y,a=ln c1,b=c2,则得到直线方程z=bx+a.
将表1 中的数据进行代换,得到的数据见表2(结果保留三位小数)
表2
x
60
80
100
120
140
150
160
170
z(=ln y) 1.813 2.302 2.709 3.041 3.438 3.660 3.855 4.008
图2 是根据表2 中数据作出的散点图.
从图2 中可以看出,变换后的样本点分布在一条直线的附近,说明z 和x 之间具有线性相关关系,因此可以用线性回
归方程来拟合.
对表2 中的数据,用最小二乘法可得线性回归方程为^z=0.020x+0.686.
再利用y=ez可得到转化率y 关于反应时间x 的非线性回归方程为^y=e0.686·e0.020x≈1.986e0.020x.
【🚀衔接高考】
(1) (2020·全国Ⅰ卷)某校一个课外学习小组为研究某作物种子的发芽率y 和温度x(单位:℃)的关系,在20 个
不同的温度条件下进行种子发芽实验,由实验数据(xi,yi)(i=1,2,…,20)得到下面的散点图:
由此散点图,在10 ℃至40 ℃之间,下面四个回归方程类型中最适宜作为发芽率y 和温度x 的回归方程类型的是(
)
A.y=a+bx                  B.y=a+bx2            C.y=a+bex                 D.y=a+bln x
【答案】D
【解析】由散点图可以看出,这些点大致分布在对数型函数的图象附近.故选D.
(2)(2025·上海高考)2024 年巴黎奥运会,中国获得了男子
米混合泳接力金牌.以下是历届奥运会
男子
米混合泳接力项目冠军成绩记录(单位:秒),数据按照升序排列.
206.78
207.46
207.95
209.34
209.35
210.68
213.73
214.84
216.93
216.93
(1)求这组数据的极差与中位数;
(2)从这10 个数据中任选3 个,求恰有2 个数据在211 以上的概率;
(3)若比赛成绩y 关于年份x 的回归方程为
,年份x 的平均数为2006,预测2028 年冠军队的成
绩(精确到0.01 秒).
【解析】(1)由题意,数据的最大值为
,最小值为
,则极差为
;
数据中间两数为
与
则中位数为
.故极差为
,中位数为
;
(2)由题意,数据共
个,
以上数据共有
个,故设事件
“恰有
个数据在
以上”,
则
,故恰有
个数据在
以上的概率为
;
(3)由题意,成绩的平均数
,由直线
过
,
则
,
故回归直线方程为
.
当
时,
.故预测
年冠军队的成绩为
秒.
🎯读教材-----玩味阅读材料
【阅读】通过阅读《拓展阅读——相关系数与向量夹角的余弦》(人教B 版选择性必修第二册P111),可从中提
炼出如下结论:相关系数r 可表示为两个向量夹角的余弦.
【证明】对于n 对数据(x1,y1),(x2,y2),…,(xn,yn),设点A1(x1,y1),A2(x2,y2),…,An(xn,yn),取点M(x,y),
其中x= x1+ x2+…+ xn
n
,y= y1+ y2+…+ yn
n
,令a=(x1-x,x2-x,…,xn-x),b=(y1-y,y2-y,…,yn-y),
则cos<a,b>=
a·b
|a||b| =
n
∑
i=1
( xi- x)( yi- y)
❑√
n
∑
i=1
( xi- x)
2·❑√
n
∑
i=1
( yi- y)
2
=r.
【🚀衔接高考】
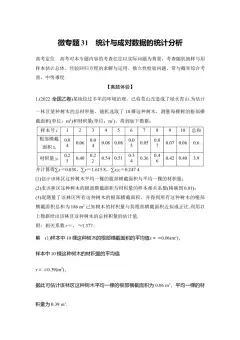
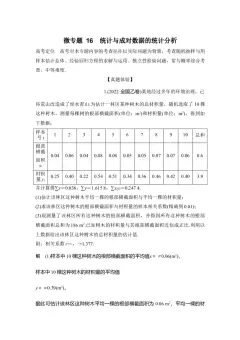
 (1)(2022·全国乙卷)某地经过多年的环境治理,已将荒山改造成了绿水青山.为估计一林区某种树木的总材积
量,随机选取了10 棵这种树木,测量每棵树的根部横截面积(单位:m2)和材积量(单位:m3),得到如下数据:
样本号i
根部横截面积xi
材积量yi
1
0.04
0.25
2
0.06
0.40
3
0.04
0.22
4
0.08
0.54
5
0.08
0.51
6
0.05
0.34
7
0.05
0.36
8
0.07
0.46
9
0.07
0.42
10
0.06
0.40
总和
0.6
3.9
并计算得
10
∑
i=1
xi
2=0.038,
10
∑
i=1
yi
2=1.615 8,
10
∑
i=1
xiyi=0.247 4.
①估计该林区这种树木平均一棵的根部横截面积与平均一棵的材积量;
②求该林区这种树木的根部横截面积与材积量的样本相关系数(精确到0.01);
③现测量了该林区所有这种树木的根部横截面积,并得到所有这种树木的根部横截面积总和为186 m2.已知树木的
材积量与其根部横截面积近似成正比.利用以上数据给出该林区这种树木的总材积量的估计值.
附:相关系数r=
n
∑
i=1
( xi- x)( yi- y)
❑√
n
∑
i=1
( xi- x)
2n
∑
i=1
( yi- y)
2
,❑√1.896≈1.377.
【解析】①样本中10 棵这种树木的根部横截面积的平均值x=0.6
10 =0.06(m2),
样本中10 棵这种树木的材积量的平均值y=3.9
10 =0.39(m3),
据此可估计该林区这种树木平均一棵的根部横截面积为0.06 m2,平均一棵的材积量为0.39 m3.
②r=
10
∑
i=1
( xi- x)( yi- y)
❑√
10
∑
i=1
( xi- x)
210
∑
i=1
( yi- y)
2
=
10
∑
i=1
xi yi-10 x y
❑√
(
10
∑
i=1
xi
2-10 x
2)(
10
∑
i=1
yi
2-10 y
2)
=
0.247 4 -10×0.06×0.39
❑√(0.038-10×0.06
2)(1.615 8-10×0.39
2)
=
0.013 4
❑√0.000 189 6
≈0.013 4
0.013 77 ≈0.97.
③设该林区这种树木的总材积量的估计值为Y m3,
又已知树木的材积量与其根部横截面积近似成正比,可得0.06
0.39=186
Y ,解得Y=1 209.
则该林区这种树木的总材积量估计为1 209 m3.
(2)(2020·全国Ⅱ卷)某沙漠地区经过治理,生态系统得到很大改善,野生动物数量有所增加.为调查该地区某种
野生动物的数量,将其分成面积相近的200 个地块,从这些地块中用简单随机抽样的方法抽取20 个作为样区,调查
得到样本数据(xi,yi)(i=1,2,…,20),其中xi和yi分别表示第i 个样区的植物覆盖面积(单位:公顷)和这种野生动物的数
量,并计算得
20
∑
i=1
xi=60,
20
∑
i=1
yi=1 200,
20
∑
i=1
(xi-x)2=80,
20
∑
i=1
(yi-y)2=9 000,
20
∑
i=1
(xi-x)(yi-y)=800.
①求该地区这种野生动物数量的估计值(这种野生动物数量的估计值等于样区这种野生动物数量的平均数乘以地
块数);
②求样本(xi,yi)(i=1,2,…,20)的相关系数(精确到0.01);
③根据现有统计资料,各地块间植物覆盖面积差异很大.为提高样本的代表性以获得该地区这种野生动物数量更准
确的估计,请给出一种你认为更合理的抽样方法,并说明理由.
附:相关系数r=
n
∑
i=1
( xi- x)( yi- y)
❑√
n
∑
i=1
( xi- x)
2n
∑
i=1
( yi- y)
2
,❑√2≈1.414.
【解析】①由已知得样本平均数y= 1
20
20
∑
i=1
yi=60,从而该地区这种野生动物数量的估计值为60×200=12 000.
②样本(xi,yi)(i=1,2,…,20)的相关系数r=
20
∑
i=1
( xi- x)( yi- y)
❑√
20
∑
i=1
( xi- x)
220
∑
i=1
( yi- y)
2
=
800
❑√80×9 000=2❑√2
3
≈0.94.
③分层抽样:根据植物覆盖面积的大小对地块分层,再对200 个地块进行分层抽样.
理由如下:由②知各样区的这种野生动物数量与植物覆盖面积有很强的正相关性.由于各地块间植物覆盖面积差异
很大,从而各地块间这种野生动物数量差异也很大,采用分层抽样的方法较好地保持了样本结构与总体结构的一致
性,提高了样本的代表性,从而可以获得该地区这种野生动物数量更准确的估计.
🎯研教材-----深度探究思考
【探究1】(人教A 版必修第二册P206)平均数和中位数都描述了数据的集中趋势,它们的大小关系和数据分布的
形态有关.在图中的三种分布形态中,平均数和中位数的大小存在什么关系?
【解析】一般来说,对一个单峰的频率分布直方图来说,如果直方图的形状是对称的(图(1)),那么平均数和中位数应
该大体上差不多;如果直方图在右边“拖尾”(图(2)),那么平均数大于中位数;如果直方图在左边“拖尾”(图(3)),
那么平均数小于中位数,也就是说,和中位数相比,平均数总是在“长尾巴”那边.
【探究2】(人教B 版选择性必修第二册P106)假设y 与x 具有相关关系,而且回归直线方程为^y=^bx+^a,完成下列
任务:
(1)将^a=y-^b x代入回归直线方程,并求出x=x时^y的值;
(2)判断一次函数^y=^bx+^a的单调性由谁决定,指出函数的单调性与正相关、负相关之间的联系;
(3)通过计算说明,当x 每增大一个单位时,^y将如何变化,并总结出这一结论的实际意义.
【解析】(1)将^a=y-^b x代入^y=^bx+^a后,整理可得^y-y=^b(x-x),这说明回归直线一定过点(x,y).
(2)一次函数^y=^bx+^a的单调性当然是^b的符号决定的,函数递增的充要条件是^b>0,即y 与x 正相关的充要条件是^b
>0;y 与x 负相关的充要条件是^b<0.
(3)如果(x1,^y1)和(x2,^y2)都是回归直线上的点,则{
^y1= ^b x1+ ^a,①
^y2= ^b x2+ ^a,②
由②式减去①式可得^y2-^y1=^b(x2-x1),这就说明,若x2-x1=1,则^y2-^y1=^b.
也就是说,当x 增大一个单位时,^y增大^b个单位,这就是回归系数^b的实际意义.
【探究3】(人教A 版必修第二册P218T11 拓展)分层随机抽样的平均数和方差公式:已知总体划分为3 层,通过分
层随机抽样,各层抽取的样本量、样本平均数和样本方差分别为:l,x,s1
2;m,y,s2
2;n,z,s3
2.记总的样本平均数为w,样本
方差为s2,证明:
(1)w=
l
l+m+n x+
m
l+m+n y+
n
l+m+n z;
(2)s2=
1
l+m+n{l[s1
2+(x-w)2]+m[s2
2+(y-w)2]+n[s3
2+(z-w)2]}.
【证明】 (1)w=l x +m y +n z
l+m+n
=
l
l+m+n x+
m
l+m+n y+
n
l+m+n z.
(2)s2=
1
l+m+n[
l
∑
i=1
(xi-w)2+
m
∑
j=1
(yj-w)2+
n
∑
k=1
(zk-w)2]=
1
l+m+n[
l
∑
i=1
(xi-x+x-w)2+
m
∑
j=1
(yj-y+y-w)2+
n
∑
k=1
(zk-z+z-w)2],
由
l
∑
i=1
(xi-x)=
l
∑
i=1
xi-lx=0,可得
l
∑
i=1
2(xi-x)(x-w)=2(x-w)
l
∑
i=1
(xi-x)=0,同理
m
∑
j=1
2(yj-y)(y-w)=0,
n
∑
k=1
2(zk-z)(z-w)=0,因此s2=
1
l+m+n[
l
∑
i=1
(xi-x)2+
l
∑
i=1
(x-w)2+
m
∑
j=1
(yj-y)2+
m
∑
j=1
(y-w)2+
n
∑
k=1
(zk-z)2+
n
∑
k=1
(z-w)2]
=
1
l+m+n{l[s1
2+(x-w)2]+m[s2
2+(y-w)2]+n[s3
2+(z-w)2]}.
【🚀新题预测】
 (2026·湖南长沙模拟)树人中学高三(1)班某次数学质量检测(满分150 分)的统计数据如表:
性别
参加考试人数
平均成绩
标准差
男
30
100
16
女
20
90
19
在按比例分配分层随机抽样中,已知总体划分为2 层,把第一层样本记为x1,x2,x3,…,xn,其平均数记为x,方差记为s1
2;
把第二层样本记为y1,y2,y3,…,ym,其平均数记为y,方差记为s2
2;把总样本数据的平均数记为z,方差记为s2.
(1)证明:s2=
1
m+n{n[s1
2+(x-z)2]+m[s2
2+(y-z)2]};
(2)求该班参加考试学生成绩的平均数和标准差(精确到1);
(3)假设全年级学生的考试成绩服从正态分布N(μ,σ2),以该班参加考试学生成绩的平均数和标准差分别作为μ
和σ 的估计值.如果按照16%,34%,34%,16%的比例将考试成绩从高分到低分依次划分为A,B,C,D 四个等级,试确定
各等级的分数线(精确到1).
附:P(μ-σ≤X≤μ+σ)≈0.68,❑√302≈17,❑√322≈18,❑√352≈19.
(1)证明 s2=
1
m+n[
n
∑
i=1
(xi-z)2+
n
∑
i=1
(yi-z)2]=
1
m+n[
n
∑
i=1
(xi-x+x-z)2+
m
∑
i=1
(yi-y+y-z)2]
=
1
m+n{
n
∑
i=1
[(xi-x)2+(x-z)2+2(xi-x)(x-z)]+
m
∑
i=1
[(yi-y)2+(y-z)2+2(yi-y)(y-z)]}.
∵
n
∑
i=1
[2(xi-x)(x-z)]=2(x-z)
n
∑
i=1
(xi-x)=2(x-z)(x1+x2+x3+…+xn-nx)=0,
同理
n
∑
i=1
[2(yi-y)(y-z)]=0,所以s2=
1
m+n{n[s1
2+(x-z)2]+m[s2
2+(y-z)2]}.
(2)解 将该班参加考试学生成绩的平均数记为z,方差记为s2,
则z= 1
50(30×100+20×90)=96,所以s2= 1
50{30[256+(100-96)2]+20[361+(90-96)2]}=322,
又❑√322≈18,所以s≈18.即该班参加考试学生成绩的平均数为96 分,标准差约为18 分.
(3)解 由(2)知μ=96,σ=18,所以全年级学生的考试成绩X 服从正态分布N(96,182),
所以P(96-18≤X≤96+18)≈0.68,P(X≥96)=0.5.P(78≤X≤96)=P(96≤X≤114)≈0.34,P(X≥114)=P(X<78)≈0.16.
故可将X≥114 定为A 等级,96≤X<114 定为B 等级,78≤X<96 定为C 等级,X<78 定为D 等级.
【探究4】(人教A 版选择性必修第三册P129 讲解拓展)独立性检验中统计量χ2公式:χ2=
n(ad -bc)
2
(a+b)(c +d )(a+c)(b+d )
.
【证明】
X
Y
合计
Y=0
Y=1
X=0
a
b
a+b
X=1
c
d
c+d
合计
a+c
b+d
n=a+b+c+d
事件{X=0}的概率可估计为P(X=0)=a+b
n
,  事件{Y=0}的概率可估计为P(Y=0)=a+c
n
,
事件{X=0,Y=0}的概率可估计为P(X=0,Y=0)=a
n,
零假设H0:事件{X=0}与{Y=0}独立,则P(X=0,Y=0)=P(X=0)P(Y=0)=a+b
n
·a+c
n
=(a+b)(a+c)
n
2
,
a 是事件{X=0,Y=0}成立的频数的观测值,根据频率稳定于概率的原理,np(X=0,Y=0)=n·(a+b)(a+c)
n
2
=
(a+b)(a+c)
n
是相应频数的期望值(或预期值),观测值和期望值之差的绝对值应该很小.
|a- (a+b)(a+c)
n
|=|a- (a+b)(a+c)
a+b+c +d |=|ad -bc|
n
,同理,|b- (a+b)(b+d )
n
|=|ad -bc|
n
,
|c - (a+c)(c +d)
n
|=|ad -bc|
n
, |d - (c +d)(b+d)
n
|=|ad -bc|
n
,
即|ad-bc|越小,事件{X=0}与{Y=0}独立性可能越大,将上述每个差值平方后,除以各自的期望值,再相加,用统计量是
χ2来表示,
χ2=
(ad -bc)
2
n
2
(a+b)(a+c)
n
+
(ad -bc)
2
n
2
(a+b)(b+d)
n
+
(ad -bc)
2
n
2
(a+c)(c +d)
n
+
(ad -bc)
2
n
2
(c +d)(b+d)
n
=(ad -bc)
2
n
·
[
1
(a+b)(a+c) +
1
(a+b)(b+d) +
1
(a+c)(c +d) +
1
(c +d)(b+d)]
=(ad -bc)
2
n
·[
b+d +a+c
(a+b)(a+c)(b+d) +
b+d +a+c
(a+c)(c +d)(b+d)]=(ad-bc)2·
[
1
(a+b)(a+c)(b+d ) +
1
(a+c)(c +d )(b+d )]
=(ad-bc)2·
c +d +a+b
(a+b)(a+c)(b+d)(c +d)=
n(ad -bc)
2
(a+b)(a+c)(b+d)(c +d)
.
【🚀衔接高考】
(2025·全国一卷)为研究某疾病与超声波检查结果的关系,从做过超声波检查的人群中随机调查了1000 人,
得到如下列联表:
超声波检查结果组别
正
常
不正常
合计
患该疾病
20
180
200
未患该疾病
780
20
800
合计
800
200
1000
(1)记超声波检查结果不正常者患该疾病的概率为P,求P 的估计值;
(2)根据小概率值
的独立性检验,分析超声波检查结果是否与患该疾病有关.
附
,
0.005
0.010
0.001
3.841
6.635
10.828
【解析】(1)根据表格可知,检查结果不正常的
人中有
人患病,所以
的估计值为
;
(2)零假设为
:超声波检查结果与患病无关,
根据表中数据可得,
,
根据小概率值
的
独立性检验,我们推断
不成立,即认为超声波检查结果与患该病有关,该推断
犯错误的概率不超过
.