文档文本内容
第 03 讲:统计和概率
1.事件的分类
(1)随机事件
一般地,随机试验中的每个随机事件都可以用这个试验的样本空间的子集来表示.为了叙述方便,我们将样本空
间Ω的子集称为随机事件,简称事件,并把只包含一个样本点的事件称为基本事件.随机事件一般用大写字母
A,B,C…表示.在每次试验中,当且仅当A中某个样本点出现时,称为事件A发生.
(2)必然事件
Ω作为自身的子集,包含了所有的样本点,在每次试验中总有一个样本点发生,所以Ω总会发生,我们称Ω为必
然事件.
(3)不可能事件
空集∅不包含任何样本点,在每次试验中都不会发生,我们称∅为不可能事件.
2.两个事件的关系和运算
事件的关系或运算 含义 符号表示 图形表示
包含 A发生(导致) B发生 A⊆B
并事件(和事件) A与B至少一个发生 A∪B或A+B
交事件(积事件) A与B同时发生 A∩B或AB
互斥(互不相容) A与B不能同时发生 A∩B=∅
互为对立 A与B有且仅有一个发生 A∩B=∅,A∪B=Ω
3.频率与概率
(1)事件的概率
对随机事件 发生可能性大小的度量 ( 数值 )称为事件的概率,事件A的概率用P(A)表示.
(2)频率的稳定性
一般地,随着试验次数n的增大,频率偏离概率的幅度会缩小,即事件A发生的频率f(A)会逐渐稳定于事件A发
n
生的概率P(A).我们称频率的这个性质为频率的稳定性.因此,我们可以用频率f(A)估计概率P(A).
n
(3)频率与概率的区别
本身是随机的,在试验之前是无法确定的,在相同的条件下做同样次
频率
数的重复试验,得到的事件的频率值也可能会不同概率 本身是一个在[0,1]内的确定值,不随试验结果的改变而改变
4.古典概型
具有以下特征的试验叫做古典概型试验,其数学模型称为古典概率模型,简称古典概型.
(1)有限性:样本空间的样本点只有有限个;
(2)等可能性:每个样本点发生的可能性相等.
5.古典概型的概率公式
一般地,设试验E是古典概型,样本空间Ω包含n个样本点,事件A包含其中的k个样本点,则定义事件A的概
率P(A)==. 其中,n(A)和n(Ω)分别表示事件A和样本空间Ω包含的样本点个数.
6.概率的性质
性质1:对任意的事件A,都有0≤P(A)≤1;
性质2:必然事件的概率为1,不可能事件的概率为0,即P(Ω)=1,P(∅)=0;
性质3:如果事件A与事件B互斥,那么P(A∪B)=P(A)+P(B);
性质4:如果事件A与事件B互为对立事件,那么P(B)=1-P(A),P(A)=1-P(B);
性质5:如果A⊆B,那么P(A)≤P(B),由该性质可得,对于任意事件A,因为∅⊆A⊆Ω,所以0≤P(A)≤1.
性质6:设A,B是一个随机试验中的两个事件,有P(A∪B)=P(A)+P(B)-P(A∩B).
7.简单随机抽样
(1)简单随机抽样
分为放回简单随机抽样和不放回简单随机抽样.除非特殊声明,本章简单随机抽样指不放回简单随机抽样.
(2)简单随机样本
通过简单随机抽样获得的样本称为简单随机样本.
(3)简单随机抽样的常用方法
实现简单随机抽样的方法很多,抽签法和随机数法是比较常用的两种方法.
8.总体平均数与样本平均数
名称 定义
一般地,总体中有N个个体,它们的变量值分别为Y,Y,…,Y ,
1 2 N
则称== 为总体均值,又称总体平均数.
总体均值 如果总体的N个变量值中,不同的值共有k(k≤N)个,不妨记为Y,Y,…,
1 2
(总体平均数) Y,其中Y出现的频数f(i=1,2,…,k),则总体均值还可以写成加权平均数的
k i i
形式
= .
样本均值 如果从总体中抽取一个容量为n的样本,它们的变量值分别为y,y,…,y,
1 2 n(样本平均数) 则称== 为样本均值,又称样本平均数.
说明:(1)在简单随机抽样中,我们常用样本平均数去估计总体平均数;
(2)总体平均数是一个确定的数,样本平均数具有随机性(因为样本具有随机性);
(3)一般情况下,样本量越大,估计越准确
9.分层随机抽样
(1)分层随机抽样的概念
一般地,按一个或多个变量把总体划分成若干个子总体,每个个体属于且仅属于一个子总体,在每个子总体中独
立地进行简单随机抽样,再把所有子总体中抽取的样本合在一起作为总样本,这样的抽样方法称为分层随机抽样,
每一个子总体称为层.
(2)分层随机抽样的平均数计算
在分层随机抽样中,以层数是2层为例,如果第1层和第2层包含的个体数分别为M和N,抽取的样本量分别为m
和n,第1层和第2层的样本平均数分别为,,样本平均数为,
则=+=+.
我们可以用样本平均数估计总体平均数.
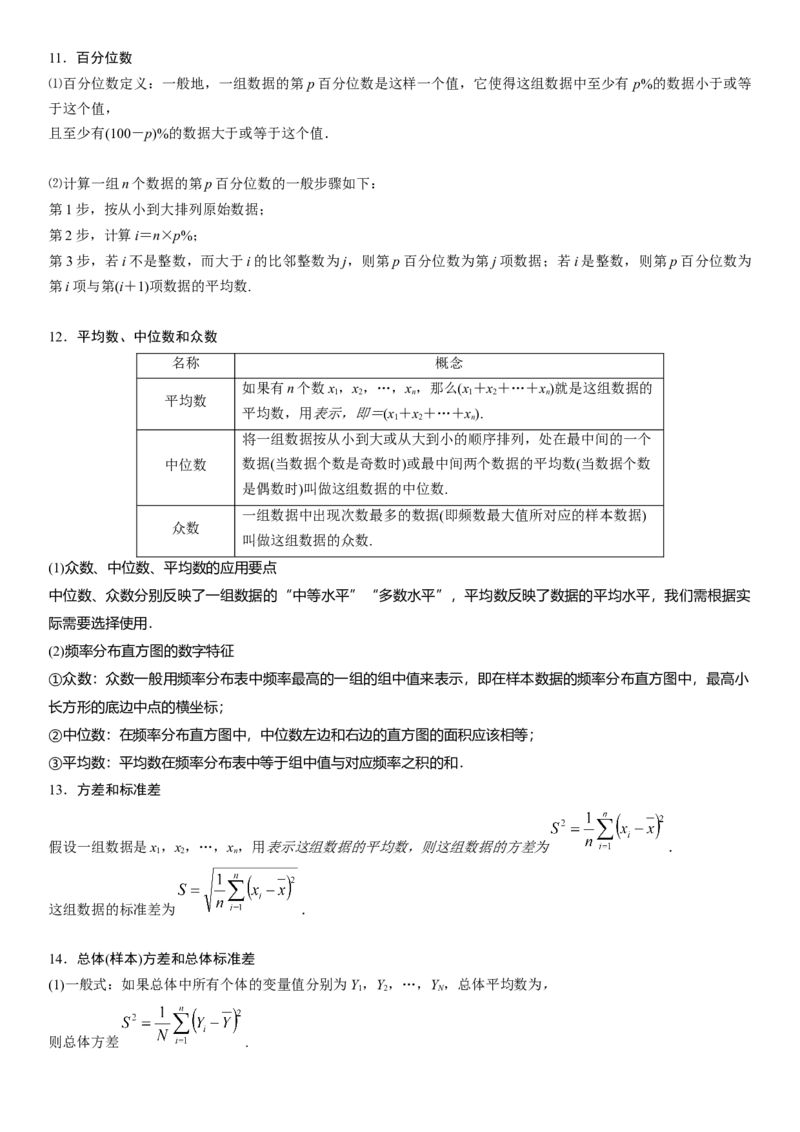
10.统计图表
(1)常见的统计图表有条形图、扇形图、折线图、频数分布直方图、频率分布直方图等.
(2)频率分布表、频率分布直方图的制作步骤及意义11.百分位数
⑴百分位数定义:一般地,一组数据的第p百分位数是这样一个值,它使得这组数据中至少有 p%的数据小于或等
于这个值,
且至少有(100-p)%的数据大于或等于这个值.
⑵计算一组n个数据的第p百分位数的一般步骤如下:
第1步,按从小到大排列原始数据;
第2步,计算i=n×p%;
第3步,若i不是整数,而大于i的比邻整数为j,则第p百分位数为第j项数据;若i是整数,则第p百分位数为
第i项与第(i+1)项数据的平均数.
12.平均数、中位数和众数
名称 概念
如果有n个数x,x,…,x,那么(x+x+…+x)就是这组数据的
1 2 n 1 2 n
平均数
平均数,用表示,即=(x+x+…+x).
1 2 n
将一组数据按从小到大或从大到小的顺序排列,处在最中间的一个
中位数 数据(当数据个数是奇数时)或最中间两个数据的平均数(当数据个数
是偶数时)叫做这组数据的中位数.
一组数据中出现次数最多的数据(即频数最大值所对应的样本数据)
众数
叫做这组数据的众数.
(1)众数、中位数、平均数的应用要点
中位数、众数分别反映了一组数据的“中等水平”“多数水平”,平均数反映了数据的平均水平,我们需根据实
际需要选择使用.
(2)频率分布直方图的数字特征
①众数:众数一般用频率分布表中频率最高的一组的组中值来表示,即在样本数据的频率分布直方图中,最高小
长方形的底边中点的横坐标;
②中位数:在频率分布直方图中,中位数左边和右边的直方图的面积应该相等;
③平均数:平均数在频率分布表中等于组中值与对应频率之积的和.
13.方差和标准差
假设一组数据是x,x,…,x,用表示这组数据的平均数,则这组数据的方差为 .
1 2 n
这组数据的标准差为 .
14.总体(样本)方差和总体标准差
(1)一般式:如果总体中所有个体的变量值分别为Y,Y,…,Y ,总体平均数为,
1 2 N
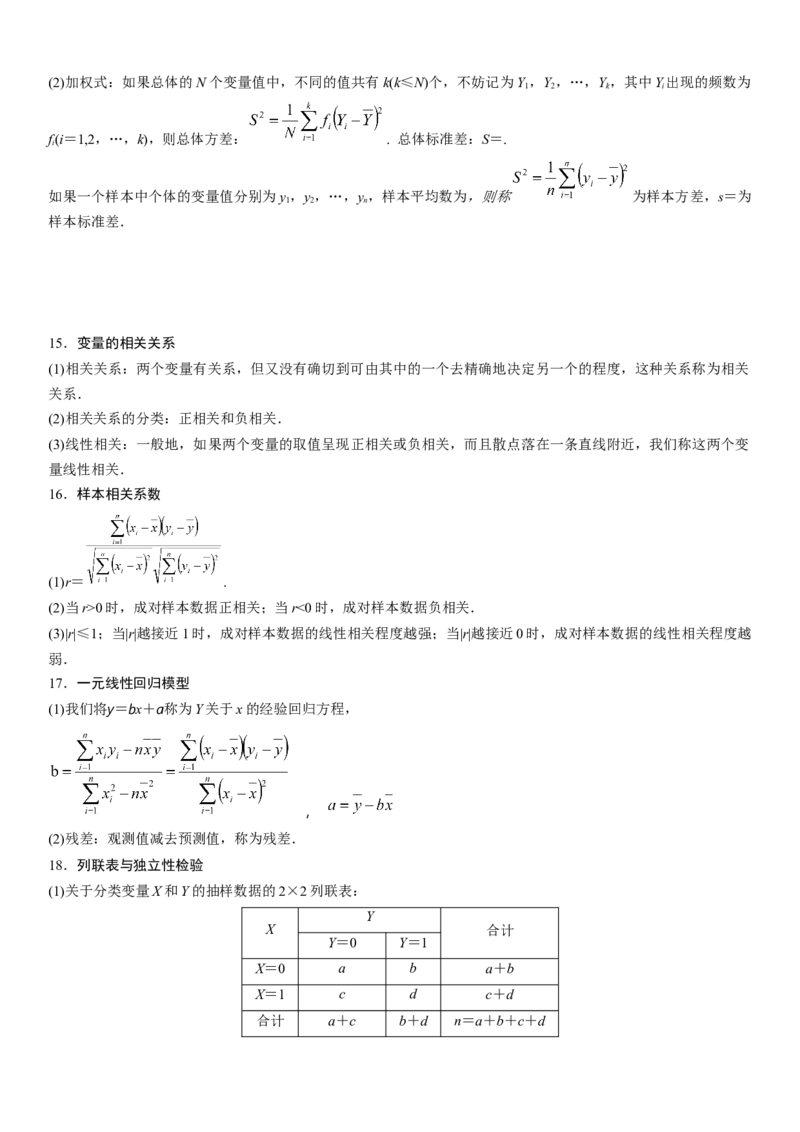
则总体方差 .(2)加权式:如果总体的N个变量值中,不同的值共有k(k≤N)个,不妨记为Y ,Y ,…,Y,其中Y出现的频数为
1 2 k i
f(i=1,2,…,k),则总体方差: . 总体标准差:S=.
i
如果一个样本中个体的变量值分别为y ,y ,…,y ,样本平均数为,则称 为样本方差,s=为
1 2 n
样本标准差.
15.变量的相关关系
(1)相关关系:两个变量有关系,但又没有确切到可由其中的一个去精确地决定另一个的程度,这种关系称为相关
关系.
(2)相关关系的分类:正相关和负相关.
(3)线性相关:一般地,如果两个变量的取值呈现正相关或负相关,而且散点落在一条直线附近,我们称这两个变
量线性相关.
16.样本相关系数
(1)r= .
(2)当r>0时,成对样本数据正相关;当r<0时,成对样本数据负相关.
(3)|r|≤1;当|r|越接近1时,成对样本数据的线性相关程度越强;当|r|越接近0时,成对样本数据的线性相关程度越
弱.
17.一元线性回归模型
(1)我们将y=bx+a称为Y关于x的经验回归方程,
,
(2)残差:观测值减去预测值,称为残差.
18.列联表与独立性检验
(1)关于分类变量X和Y的抽样数据的2×2列联表:
Y
X 合计
Y=0 Y=1
X=0 a b a+b
X=1 c d c+d
合计 a+c b+d n=a+b+c+d(2)计算随机变量χ2=,利用χ2的取值推断分类变量X和Y是否独立的方法称为χ2独立性检验.
(3)独立性检验的一般步骤①根据样本数据制成2×2列联表.②根据公式χ2=计算.
③比较χ2与临界值的大小关系,作统计推断.
题型一、随机抽样
1.(2023·辽宁抚顺·校考模拟预测)2022年第22届卡塔尔世界杯决赛中,来自南美洲的阿根廷队战胜来自欧洲的
法国队,夺得冠军,这22届世界杯冠军中,10个在南美洲,12个在欧洲.某专栏记者拟撰写一篇文章,按分层抽
样的方法抽取11个冠军队伍对两大洲足球风格进行分析比较,则需从南美洲抽取的球队个数为( )
A.3 B.4 C.5 D.6
【答案】C
【分析】根据分层抽样运算求解.
【详解】根据分层抽样可得:需从南美洲抽取的球队个数为 个.
故选:C.
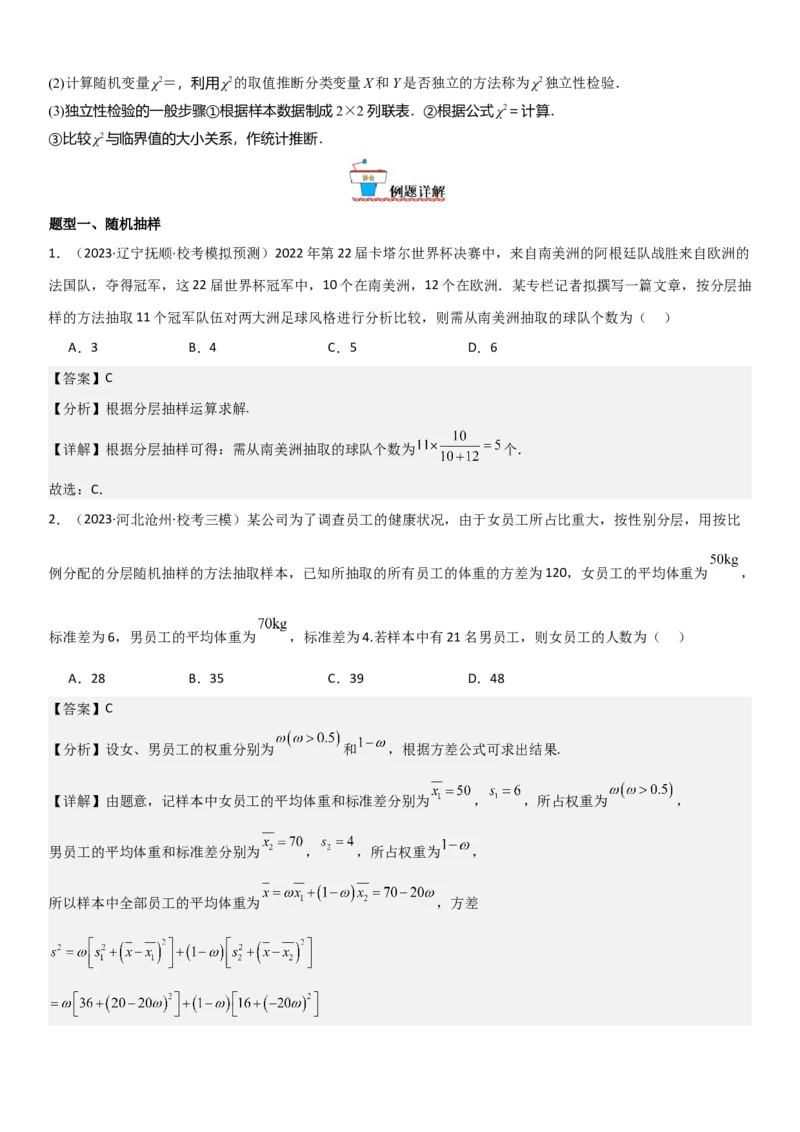
2.(2023·河北沧州·校考三模)某公司为了调查员工的健康状况,由于女员工所占比重大,按性别分层,用按比
例分配的分层随机抽样的方法抽取样本,已知所抽取的所有员工的体重的方差为120,女员工的平均体重为 ,
标准差为6,男员工的平均体重为 ,标准差为4.若样本中有21名男员工,则女员工的人数为( )
A.28 B.35 C.39 D.48
【答案】C
【分析】设女、男员工的权重分别为 和 ,根据方差公式可求出结果.
【详解】由题意,记样本中女员工的平均体重和标准差分别为 , ,所占权重为 ,
男员工的平均体重和标准差分别为 , ,所占权重为 ,
所以样本中全部员工的平均体重为 ,方差,
化简得 ,即 ,
解得 或 (舍),
所以女员工的人数为: ,
故选:C.
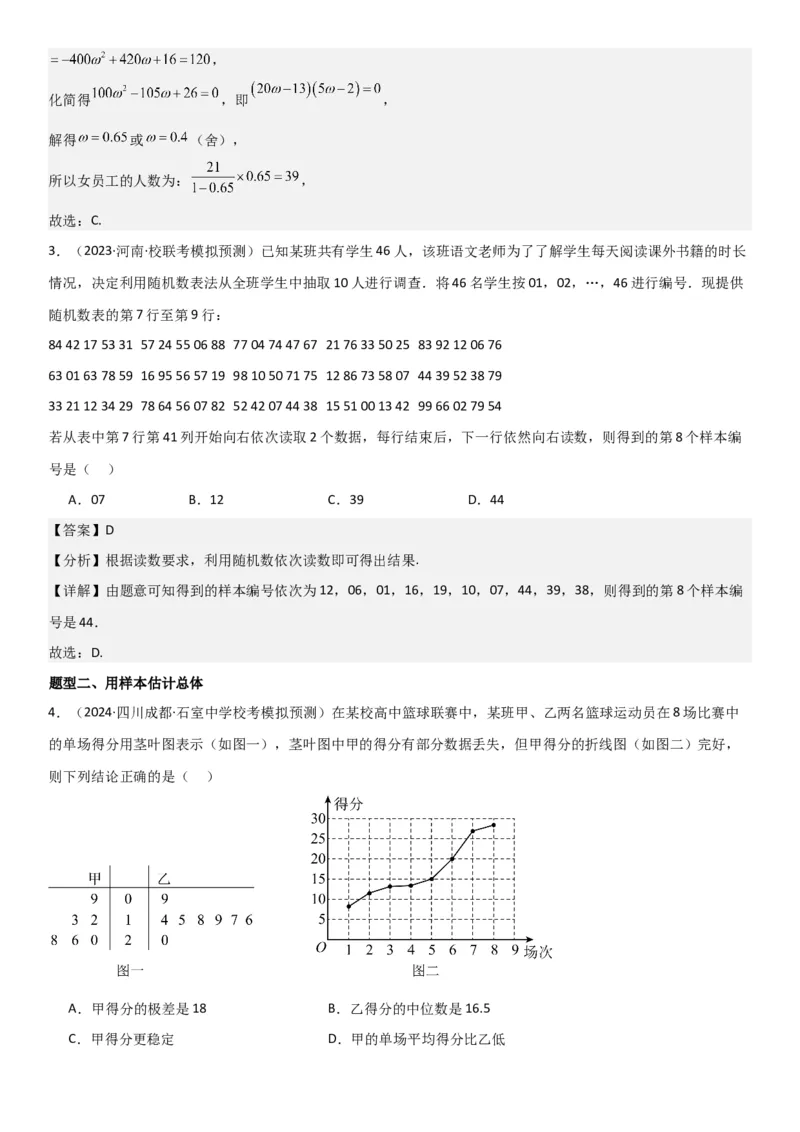
3.(2023·河南·校联考模拟预测)已知某班共有学生46人,该班语文老师为了了解学生每天阅读课外书籍的时长
情况,决定利用随机数表法从全班学生中抽取10人进行调查.将46名学生按01,02,…,46进行编号.现提供
随机数表的第7行至第9行:
84 42 17 53 31 57 24 55 06 88 77 04 74 47 67 21 76 33 50 25 83 92 12 06 76
63 01 63 78 59 16 95 56 57 19 98 10 50 71 75 12 86 73 58 07 44 39 52 38 79
33 21 12 34 29 78 64 56 07 82 52 42 07 44 38 15 51 00 13 42 99 66 02 79 54
若从表中第7行第41列开始向右依次读取2个数据,每行结束后,下一行依然向右读数,则得到的第8个样本编
号是( )
A.07 B.12 C.39 D.44
【答案】D
【分析】根据读数要求,利用随机数依次读数即可得出结果.
【详解】由题意可知得到的样本编号依次为12,06,01,16,19,10,07,44,39,38,则得到的第8个样本编
号是44.
故选:D.
题型二、用样本估计总体
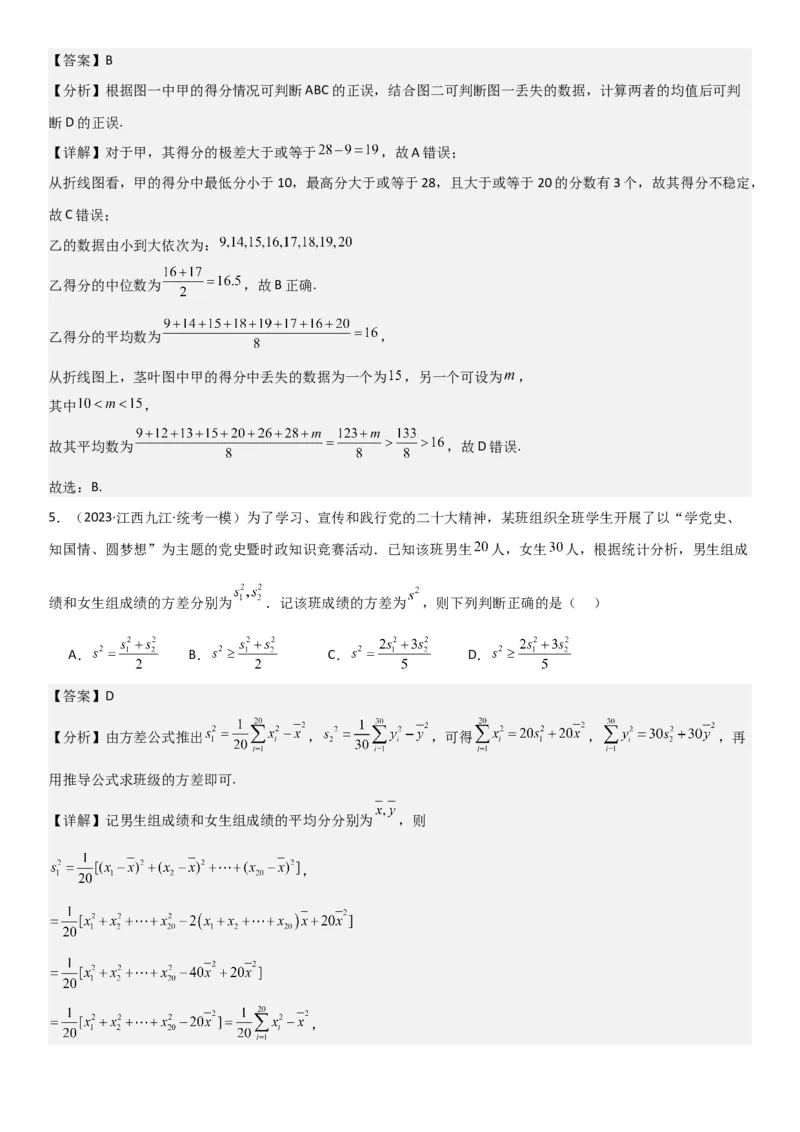
4.(2024·四川成都·石室中学校考模拟预测)在某校高中篮球联赛中,某班甲、乙两名篮球运动员在8场比赛中
的单场得分用茎叶图表示(如图一),茎叶图中甲的得分有部分数据丢失,但甲得分的折线图(如图二)完好,
则下列结论正确的是( )
A.甲得分的极差是18 B.乙得分的中位数是16.5
C.甲得分更稳定 D.甲的单场平均得分比乙低【答案】B
【分析】根据图一中甲的得分情况可判断ABC的正误,结合图二可判断图一丢失的数据,计算两者的均值后可判
断D的正误.
【详解】对于甲,其得分的极差大于或等于 ,故A错误;
从折线图看,甲的得分中最低分小于10,最高分大于或等于28,且大于或等于20的分数有3个,故其得分不稳定,
故C错误;
乙的数据由小到大依次为:
乙得分的中位数为 ,故B正确.
乙得分的平均数为 ,
从折线图上,茎叶图中甲的得分中丢失的数据为一个为 ,另一个可设为 ,
其中 ,
故其平均数为 ,故D错误.
故选:B.
5.(2023·江西九江·统考一模)为了学习、宣传和践行党的二十大精神,某班组织全班学生开展了以“学党史、
知国情、圆梦想”为主题的党史暨时政知识竞赛活动.已知该班男生 人,女生 人,根据统计分析,男生组成
绩和女生组成绩的方差分别为 .记该班成绩的方差为 ,则下列判断正确的是( )
A. B. C. D.
【答案】D
【分析】由方差公式推出 , ,可得 , ,再
用推导公式求班级的方差即可.
【详解】记男生组成绩和女生组成绩的平均分分别为 ,则
,
,同理 ,
, , ,
,
故选:D.
6.(2023·甘肃张掖·高台县第一中学校考模拟预测)2022年,我国彩电、智能手机、计算机等产量继续排名全球
第一,这标志着我国消费电子产业已经实现从“跟随”到“引领”的转变,开启了高质量发展的新时代.如图是
2022年3月至12月我国彩电月度产量及增长情况统计图(单位:万台,%),则关于这10个月的统计数据,下列
说法正确的是( )(注:同比,即和去年同期相比)
A.这10个月我国彩电月度产量的中位数为1726万台
B.这10个月我国彩电月度平均产量不超过1600万台
C.自2022年9月起,各月我国彩电月度产量均同比下降
D.这10个月我国彩电月度产量同比增长率的极差不超过0.4
【答案】D
【分析】根据条形图结合中位数,平均数和极差定义分别判断各个选项即可.
【详解】将这10个月我国彩电月度产量(单位:万台)按从小到大排列依次为1513,1540,1553,1650,1727,
1783,1802,1846,1926,2097,
中位数为第5个数与第6个数的平均数,即 ,A错误;这10个月我国彩电月度平均产量 万台,
B错误;
自2022年9月起,我国彩电月度产量虽然逐月减少,但同比是与去年同月相比,
由同比增长率可知,9月、10月、11月的同比增长率均为正数,故月度产量同比有所增长,C错误;
由题图可知,这10个月产量的同比增长率的最大值与最小值分别为25.6%与-8.3%,
故其极差为 ,故D正确.
故选:D.
题型三、古典概型
7.(2023·湖南郴州·统考一模)湖南第二届旅游发展大会于2023年9月15日至17日在郴州举行,为让广大学生
知晓郴州,热爱郴州,亲身感受“走遍五大洲,最美有郴州”绿色生态研学,现有甲,乙两所学校从万华岩中小
学生研学实践基地,王仙岭旅游风景区,雄鹰户外基地三条线路中随机选择一条线路去研学,记事件A为“甲和
乙至少有一所学校选择万华岩中小学生研学实践基地”,事件B为“甲和乙选择研学线路不同”,则
( )
A. B. C. D.
【答案】B
【分析】利用古典概率求出事件 的概率,再利用条件概率公式计算即得.
【详解】依题意,甲,乙随机选择一条线路去研学的试验有 个基本事件,
事件A含有的基本事件数是 ,则 ,
事件 含有的基本事件数为 ,则 ,
所以 .
故选:B
8.(2023·河南·校联考模拟预测)如图,A,B,C三个开关控制着1,2,3,4号四盏灯,其中开关A控制着2,
3,4号灯,开关B控制着1,3,4号灯,开关C控制着1,2,4号灯.开始时,四盏灯都亮着.现先后按动A,B,C
这三个开关中的两个不同的开关,则其中1号灯或2号灯亮的概率为( )A. B. C. D.
【答案】D
【分析】根据题意利用列举法求解古典概型的概率.
【详解】先后按动A,B,C中的两个不同的开关,有 种方法,
若要1号灯亮,则按第一个开关时,1号灯灭,按第二个开关时,1号灯亮,
此时对应的方法有2种: , ;
若要2号灯亮,同理可得有以下2种方法: , ;
可知:要1号灯或2号灯亮有 种方法,
故所求的概率为 .
故选:D.
9.(2023·江西景德镇·统考三模)写算,是一种格子乘法,也是笔算乘法的一种,用以区别筹算与珠算,它由明
代数学家吴敬在其撰写的《九章算法比类大全》一书中提出,是从天元式的乘法演变而来.例如计算 ,将
被乘数89计入上行,乘数61计入右行,然后以乘数61的每位数字乘被乘数89的每位数字,将结果计入相应的格
子中,最后从右下方开始按斜行加起来,满十向上斜行进一,如图,即得5429,若从表内的8个数字(含相同的
数字,表周边数据不算在内)中取1个数字,这个数字大于5的概率为( )
A. B. C. D.【答案】B
【分析】根据古典概型的概率公式计算可得.
【详解】表内的 个数字分别为 , , , , , , , ,其中大于 的有 , , ,
从表内的 个数字(含相同的数字,表周边数据不算在内)中取1个数字有 种取法,
这个数字大于 的情况有 种取法,
这个数字大于 的概率为 .
故选:B.
题型四、变量间的相关关系
10.(2024·四川成都·石室中学校考模拟预测)某老师为了了解数学学习成绩得分y(单位:分)与每天数学学习
时间x(单位:分钟)是否存在线性关系,搜集了100组数据 ,并据此求得y关于x的
线性回归方程为 .若一位同学每天数学学习时间约80分钟,则可估计这位同学数学成绩为( )
A.106 B.122 C.136 D.140
【答案】C
【分析】利用回归方程经过样本中心可求 ,故可估计这位同学每天数学学习时间约80分钟后的数学成绩.
【详解】由题设可得 ,
故 ,故 ,故 ,
故当 时, ,
故选:C.
11.(2023·福建宁德·福建省宁德第一中学校考二模)5G技术在我国已经进入高速发展的阶段,5G手机的销量也
逐渐上升,某手机商城统计了最近5个月手机的实际销量,如下表所示:
时间x 1 2 3 4 5
销售量y(千只) 0.5 0.8 1.0 1.2 1.5
若y与x线性相关,且线性回归方程为 ,则下列说法不正确的是( )
A.由题中数据可知,变量y与x正相关B.线性回归方程 中
C.可以预测 时该商场5G手机销量约为1.72(千只)
D. 时,残差为
【答案】D
【分析】对于 ,利用表中的数据分析即可求解;对于 ,利用平均数的定义及样本中心,结合样本中心在回归
直线上即可求解;对于 ,利用预测值和残差的定义即可求解;对于 ,利用回归方程即可求出预测值.
【详解】对于 ,从数据看 随 的增加而增加,所以变量y与x正相关,故 正确;
对于 ,由表中数据知,
所以样本中心点为 ,将样本中心点 代入 中得 ,故 正确;
对于 ,当 时该商场5G手机销量约为 (千只),故 正确.
对于 ,线性回归方程为 ,所以 , ,故 错误;
故选: .
12.(2023·江西赣州·统考模拟预测)在南极,东南极冰盖被称为“沉睡的巨人”,是世界上最大的大陆冰川,包
含了世界上大部分的冰.2022年在英国《自然》杂志发表的一篇论文指出,若《巴黎协定》的控温目标未能达成,
东南极冰盖会因气候变化影响而加速融化,到2500年,可能导致海平面上升2到5米.无独有偶,2023年发表于
《科学》杂志的新研究中,法国图卢兹空间地球物理学和海洋学研究实验室领衔的国际团队揭示了比之前预测的
更大的冰川质量损失,全球温度升高与冰川质量损失之间存在线性相关关系,有如下数据:
温度上升量x(℃) 0.4 0.7 1.0 1.2 1.8 2.4
冰川消融百分比y(%) 12 24 32 45 56 77
根据数据,绘制如图所示的散点图,则下列说法正确的是①冰川消融百分比与温度
上升量存在正相关关系;②由表中数据用最小二乘法得到的线性回归直线一定经过点 ;③记表中数据
的方差为 ,若控温措施有效,则冰川消融百分比将变为z%,且 ,那么 的方差将变为 .( )
A.① B.③ C.①② D.②③
【答案】A
【分析】对于①,由散点图即可判断;对于②,根据线性回归直线一定经过点样本点中心即可判断;对于③,由
方差的性质即可判断.
【详解】对于①,由散点图可得冰川消融百分比与温度上升量存在正相关关系,①正确;
对于②, , ,线性回归直线一定经
过点 ,②错误;
对于③,由方差的性质可得 ,③错误.
故选:A
题型五、回归分析
13.(2023·陕西宝鸡·校考模拟预测)下图是我国2014年至2020年生活垃圾无害化处理量(单位:亿吨)的折线
图.
注:年份代码1-7分别对应年份2014-2020(2021年后代码依次类推).
(1)由折线图看出,可用线性回归模型拟合y与t的关系,请用相关系数加以说明;
(2)建立y关于t的回归方程(系数精确到0.01),预测2023年我国生活垃圾无害化处理量.
附注:参考数据: .
参考公式:相关系数
回归方程 中斜率和截距的最小二乘估计公式分别为: .【答案】(1)答案见解析
(2) ,1.92亿吨
【分析】(1)根据相关系数的计算公式,直接计算求解即可;
(2)根据题意,列方程计算出回归方程,进而代入预测值,即可求解.
【详解】(1)由折线图中数据和附注中参考数据得 , , ,
,
所以 ,
因为y与t的相关系数近似为0.99,说明y与t的线性相关程度相当高,从而可以用线性回归模型拟合y与t的关系.
(2)由 及(1)得 ,
所以,y关于t的回归方程为: .
将2023年对应的 代入回归方程得: ,
所以预测2023年我国生活垃圾无害化处理量将约1.92亿吨.
14.(2023·四川绵阳·统考二模)抗体药物的研发是生物技术制药领域的一个重要组成部分,抗体药物的摄入量与
体内抗体数量的关系成为研究抗体药物的一个重要方面.某研究团队收集了10组抗体药物的摄入量与体内抗体数量
的数据,并对这些数据作了初步处理,得到了如图所示的散点图及一些统计量的值,抗体药物摄入量为x(单位:
),体内抗体数量为y(单位: ).
29.2 12 16 34.4(1)根据经验,我们选择 作为体内抗体数量y关于抗体药物摄入量x的回归方程,将 两边取对数,得
,可以看出 与 具有线性相关关系,试根据参考数据建立 关于 的回归方程,并预测抗体
药物摄入量为 时,体内抗体数量 的值;
(2)经技术改造后,该抗体药物的有效率z大幅提高,经试验统计得z服从正态分布 ,那这种抗体
药物的有效率 超过0.54的概率约为多少?
附:①对于一组数据 ,其回归直线 的斜率和截距的最小二乘估计分别为
, ;
②若随机变量 ,则有 , ,
;
③取 .
【答案】(1) ;
(2)
【分析】(1)用最小二乘法求解回归直线方程,再求非线性回归方程即可;
(2)根据正态分布的对称性求解给定区间的概率即可.
【详解】(1)将 两边取对数,得 ,
设 , ,则回归方程变为 ,
由表中数据可知, , ,所以 , ,
所以 ,即 ,
故y关于x的回归方程为 ,
当 时, .
(2)因为z服从正态分布 ,其中 , ,
所以 ,
所以 ,
故这种抗体药物的有效率z超过0.54的概率约为 .
15.(2023·湖北武汉·华中师大一附中校考模拟预测)2021年春节前,受疫情影响,各地鼓励外来务工人员选择就
地过年.某市统计了该市4个地区的外来务工人数与就地过年人数(单位:万),得到如下表格:
区 区 区
区
外来务工人数 万 3 4 5 6
就地过年人数
2.5 3 4 4.5
万
(1)请用相关系数说明 与 之间的关系可用线性回归模型拟合,并求 关于 的线性回归方程 和A区的
残差
(2)假设该市政府对外来务工人员中选择就地过年的每人发放1000元补贴.
①若该市 区有2万名外来务工人员,根据(1)的结论估计该市政府需要给 区就地过年的人员发放的补贴总金
额;
②若 区的外来务工人员中甲、乙选择就地过年的概率分别为 ,其中 ,该市政府对甲、乙两人的
补贴总金额的期望不超过1400元,求 的取值范围.
参考公式:相关系数 ,回归方程 中斜率和截距的最小二乘估计公式分别为 .
【答案】(1)答案见解析, ,0.05
(2)①1750(万元);②
【分析】(1)根据表中数据和题设给出的计算公式可求相关系数,故可用线性回归模型拟合 与 之间的关系,
求出回归方程后可求残差.
(2)①结合(1)的回归方程可估计补贴总金额;②利用独立事件的概率公式可求补贴总金额的分布列,求出其
期望后可求 的取值范围.
【详解】(1)由题, ,
,
, ,
所以相关系数 ,
因为 与 之间的相关系数近似为0.99,说明 与 之间的线性相关程度非常强,
所以可用线性回归模型拟合 与 之间的关系.
,
故 关于 的线性回归方程为 .
∵ ,∴ ,故A区的残差为0.05.
(2)(2)①将 代入 ,得 ,
故估计该市政府需要给 区就地过年的人员发放的补贴总金额为 (万元).
②设甲、乙两人中选择就地过年的人数为 ,则 的所有可能取值为0,1,2,
,,
.
所以 ,
所以 ,
由 ,得 ,又 ,所以 ,
故 的取值范围为 .
题型六、独立性检验
16.(2024·江西·校联考模拟预测)近年来,随着智能手机的普及,网络购物、直播带货、网上买菜等新业态迅速
进入了我们的生活,改变了我们的生活方式.现将一周网上买菜次数超过3次的市民认定为“喜欢网上买菜”,不
超过3次甚至从不在网上买菜的市民认定为"不喜欢网上买菜".某市 社区为了解该社区市民网上买菜情况,随机
抽取了该社区100名市民,得到的统计数据如下表所示:
不喜欢网上买
喜欢网上买菜 合计
菜
年龄不超过45岁的市民 40 10 50
年龄超过45岁的市民 20 30 50
合计 60 40 100
(1)是否有99.9%的把握认为 社区的市民是否喜欢网上买菜与年龄有关?
(2) 社区的市民李华周一、周二均在网上买菜,且周一从 , 两个买菜平台随机选择其中一个下单买菜.如果周
一选择 平台买菜,那么周二选择 平台买菜的概率为 ;如果周一选择 平台买菜,那么周二选择 平台买菜
的概率为 ,求李华周二选择平台 买菜的概率;
(3)用频率估计概率,现从 社区市民中随机抽取20名市民,记其中喜欢网上买菜的市民人数为 ,事件“
”的概率为 ,求使 取得最大值时的 的值.
参考公式: ,其中 .0.1 0.05 0.01 0.005 0.001
2.706 3.841 6.635 7.879 10.828
【答案】(1)有99.9%的把握认为 社区的市民是否喜欢网上买菜与年龄有关.
(2)
(3)12
【分析】(1)根据题意,计算出 的值即可求解;
(2)根据概率的乘法公式求解;
(3)利用二项分布求出 ,然后计算,可得结果.
【详解】(1)零假设 社区的市民是否喜欢网上买菜与年龄无关,
由题可得,
,
所以零假设不成立,
所以有99.9%的把握认为 社区的市民是否喜欢网上买菜与年龄有关.
(2)周二选择 平台买菜的情况有:
①周一选择 平台买菜,周二选择 平台买菜,概率为 ,
②周一选择 平台买菜,周二选择 平台买菜,概率为 ,
所以李华周二选择平台 买菜的概率为 .
(3)由表知,喜欢网上买菜的频率为 ,则 ,
所以
设 ,令 ,解得 , ;
,解得 ,
所以当 时, 最大,
所以使 取得最大值时的 的值为12.
17.(2023·河南·校联考模拟预测)网络直播带货作为一种新型的销售土特产的方式,受到社会各界的追捧.湖北某
地盛产夏橙,为帮助当地农民销售夏橙,当地政府邀请了甲、乙两名网红在某天通过直播带货销售夏橙.现对某时
间段100名观看直播后选择在甲、乙两名网红的直播间(以下简称甲直播间、乙直播间)购买夏橙的情况进行调
查(假定每人只在一个直播间购买夏橙),得到如下数据:
在直播间购买夏橙的情况
网民类
合计
型
在甲直播间购买 在乙直播间购买
男网民 50 5 55
女网民 30 15 45
合计 80 20 100
(1)依据小概率值 的独立性检验,能否认为网民选择在甲、乙直播间购买夏橙与性别有关联?
(2)网民黄蓉上午、下午均从甲、乙两个直播间中选择其中一个购买夏橙,且上午在甲直播间购买夏橙的概率为 .
若上午选择在甲直播间购买夏橙,则下午选择在甲直播间购买夏橙的概率为 ;若上午选择在乙直播间购买夏橙,
则下午选择在甲直播间购买夏橙的概率为 ,求黄蓉下午选择在乙直播间购买夏橙的概率;
(3)用样本分布的频率估计总体分布的概率,若共有50008名网民在甲、乙直播间购买夏橙,且网民选择在甲、乙
哪个直播间购买夏橙互不影响,记其中在甲直播间购买夏橙的网民人数为X,求使事件“ ”的概率取最大值
的k的值.
附: ,其中 .
0.1 0.05 0.01 0.005
2.706 3.841 6.635 7.879
【答案】(1)能(2)
(3)40007
【分析】(1)根据列联表信息,计算出 的观测值,结合临界值表可得出结论;
(2)根据全概率公式计算即可;
(3)根据二项分布求出在甲直播间购买夏橙的网民人数为k的概率,法一:利用组合数列不等式求解,法二,利
用作商法判断概率的单调性求解.
【详解】(1)提出零假设 :网民选择在甲、乙直播间购买夏橙与性别没有关联.
经计算得 ,
依据小概率值 的独立性检验,我们推断 不成立,
即认为网民选择在甲、乙直播间购买夏橙与性别有关联.
(2)记事件A:黄蓉上午在甲直播间购买夏橙,
事件B:黄蓉下午在乙直播间购买夏橙,
则 , , ,
由全概率公式可得 ,
所以黄蓉下午选择在乙直播间购买夏橙的概率为 .
(3)利用样本分布的频率估计总体分布的概率,
可知网民选择在甲直播间购买夏橙的概率为 ,
则 ,记 , ,
则 ,
则问题等价于求当k取何值时 取最大值.
解法1:由 ,化简得 ,即 ,所以 ,因 ,解得 ,
所以使事件“ ”的概率取最大值的k的值为40007.
解法2:因为 , ,
所以当 时, ;
当 时, ;
当 时, ,
所以 在 上单调递增,在 上单调递减.
又 ,
所以 ,
且 ,
所以当 时, 取最大值,
即使事件“ ”的概率取最大值的k的值为40007.
18.(2023·浙江·模拟预测)全民健身是全体人民增强体魄、健康生活的基础和保障,为了研究杭州市民健身的情
况,某调研小组在我市随机抽取了100名市民进行调研,得到如下数据:
每周健身次
1次 2次 3次 4次 5次 6次及6次以上
数
男 4 6 5 3 4 28
女 7 5 8 7 6 17
附: ,
0.10 0.05 0.01 0.005 0.001
2.706 3.841 6.635 7.879 10.828
(1)如果认为每周健身4次及以上的用户为“喜欢健身”;请完成 列联表,根据小概率值 的独立性检验,
判断“喜欢健身”与“性别”是否有关?(2)假设杭州市民小红第一次去健身房 健身的概率为 ,去健身房 健身的概率为 ,从第二次起,若前一次去
健身房 ,则此次不去 的概率为 ;若前一次去健身房 ,则此次仍不去 的概率为 .记第 次去健身房 健
身的概率为 ,则第10次去哪一个健身房健身的概率更大?
【答案】(1) 列联表见解析,“喜欢健身”与“性别”无关
(2)第10次去 健身房健身的概率更大
【分析】(1)先绘制 列联表,计算 的值,从而确定正确答案.
(2)根据全概率公式、递推关系求得 ,从而求得 ,由此确定正确答案.
【详解】(1)依题意, 列联表如下:
喜欢健
不喜欢健身 合计
身
男
女
合计
,
所以“喜欢健身”与“性别”无关.
(2)依题意, ,当 时, ,
则 ,
所以数列 是首项为 ,公比为 的等比数列,
所以 ,
所以 ,
所以第10次去 健身房健身的概率更大.一、单选题
19.(2023·吉林白山·统考模拟预测)2022年11月,国内猪肉、鸡蛋、鲜果、禽肉、粮食、食用油、鲜菜价格同比(与
去年同期相比)的变化情况如图所示,则下列说法正确的是( )
A.猪肉、鸡蛋、鲜果、禽肉、粮食、食用油这6种食品中,食用油价格同比涨幅最小
B.猪肉价格同比涨幅超过禽肉价格同比涨幅的5倍
C.去年11月鲜菜价格要比今年11月低
D.这7种食品价格同比涨幅的平均值超过
【答案】D
【分析】根据变化情况,逐一核对选项,即可判断.
【详解】由图可知,猪肉、鸡蛋、鲜果、禽肉、粮食、食用油这6种食品中,粮食价格同比涨幅最小,所以A错误.
,所以B错误.
去年11月鲜菜价格要比今年11月高,所以C错误.
因为
,所以D正确.
故选:D
20.(2023·河北衡水·河北衡水中学校考一模)某新能源汽车生产公司,为了研究某生产环节中两个变量 之间
的相关关系,统计样本数据得到如下表格:
由表格中的数据可以得到 与 的经验回归方程为 ,据此计算,下列选项中残差的绝对值最小的样本数
据是( )
A. B.C. D.
【答案】C
【分析】根据最小二乘法可求得 的值,从而得到经验回归方程;根据残差的求法依次验证各选项中的残差的绝对
值即可.
【详解】由表格数据知: , ,
, 经验回归方程为 ;
对于A,残差的绝对值为 ;
对于B,残差的绝对值为 ;
对于C,残差的绝对值为 ;
对于D,残差的绝对值为 ;
残差绝对值最小的样本数据是 .
故选:C.
21.(2023·海南海口·海南华侨中学校考模拟预测)为客观反映建设创新型国家进程中我国创新能力的发展情况,
国家统计局社科文司《中国创新指数(CII)研究》课题组研究设计了评价我国创新能力的指标体系和指数编制方
法.中国创新指数(China Innovation Index,CII)中有4个分指数(创新环境指数、创新投入指数、创新产出指数、
创新成效指数),下面是2005—2021年中国创新指数及分领域指数图,由图可知指数与年份正相关,则对4个分
领域指数,在建立年份值与指数值的回归模型中,相关系数最大的指数类型是( )A.创新环境指数 B.创新投入指数 C.创新产出指数 D.创新成效指数
【答案】D
【分析】本题考查成对数据的统计相关性,要求考生了解样本相关系数的统计含义.
【详解】由题图易知4个分领域指数的起始位置相同,其中创新投入指数、创新产出指数从2014年起,指数增幅
大,变化趋势明显大于另两类指数;
从2011年起,创新环境指数的波动幅度比创新成效指数的波动幅度大,创新成效指数对应的散点更趋近于某一条
直线,故其对应的相关系数最大.
故选:D.
22.(2023·陕西渭南·统考模拟预测)已知一个古典概型,其样本空间中共有12个样本点,其中事件 有6个样
本点,事件 有4个样本点,事件 有8个样本点,则 ( )
A. B. C. D.
【答案】D
【分析】依题意计算可得 , , ,再由概率的加法公式计算即可得 .
【详解】根据概率公式计算可得 , , ;
由概率的加法公式可知 ,代入计算可得
故选:D
23.(2023·河南郑州·校联考二模)已知O,A,B三地在同一水平面内,A地在O地正东方向2 处,B地在O
地北偏西 方向2 处,某测绘队员在A,B之间的直线公路上任选一点C作为测绘点,用测绘仪进行测绘,O
地为一磁场,距离其不超过 的范围内会对测绘仪等电子仪器形成干扰,使测量结果不准确,则该测绘队员能够得到准确数据的概率是( )
A. B. C. D.
【答案】A
【分析】作图分析,确定出仪器在线段 上受干扰的范围,从而确定不受干扰的范围,根据几何合概型的概率公
式,即可求得答案.
【详解】由题意知 为等腰三角形, ,且 ,
作 ,垂足为H,则 , ,
故 ;
在 上取 ,使 ,
则 ,则 ,
则该测绘队员能够得到准确数据的概率是 ,
故选:A
24.(2023·江西景德镇·统考三模)写算,是一种格子乘法,也是笔算乘法的一种,用以区别筹算与珠算,它由明
代数学家吴敬在其撰写的《九章算法比类大全》一书中提出,是从天元式的乘法演变而来.例如计算 ,将被
乘数 计入上行,乘数 计入右行,然后以乘数 的每位数字乘被乘数 的每位数字,将结果计入相应的格子
中,最后从右下方开始按斜行加起来,满十向上斜行进一,如图,即得 .若从表内的 个数字(含相同的数字,
表周边数据不算在内)中任取 个数字,则它们之和大于 的概率为( )A. B. C. D.
【答案】B
【分析】根据组合数运算、列举法和古典概型概率公式可求得结果.
【详解】从 个数字中任取 个数字,共有 个基本事件;
其中 个数字之和大于 的所有可能的结果有: , , 个 ,共 个基本事件,
所求概率 .
故选:B.
25.(2023·江苏无锡·江苏省天一中学校考模拟预测)对两组变量进行回归分析,得到不同的两组样本数据,第一
组对应的相关系数,残差平方和,决定系数分别为 , , ,第二组对应的相关系数,残差平方和,决定系数
分别为 , , ,则( )
A.若 ,则第一组变量比第二组的线性相关关系强
B.若 ,则第一组变量比第二组的线性相关关系强
C.若 ,则第一组变量比第二组变量拟合的效果好
D.若 ,则第二组变量比第一组变量拟合的效果好
【答案】B
【分析】由线性相关系数 与决定系数 的意义及残差平方和 与 的关系即可求解.
【详解】线性相关系数 越大,两个变量的线性相关性越强,故A错误,B正确;
残差平方和 越小,则决定系数 越大,从而两个变量拟合的效果越好,
残差平方和 越大,则决定系数 越小,从而两个变量拟合的效果越差,
故C、D错误.
故选:B
26.(2023·黑龙江哈尔滨·哈尔滨三中校考模拟预测)下列说法不正确的是( )
A.甲、乙、丙三种个体按 的比例分层抽样调查,若抽取的甲种个体数为9,则样本容量为18B.设一组样本数据 , ,…, 的方差为2,则数据 , ,.…, 的方差为32
C.在一个 列联表中,计算得到 的值,则 的值越接近1,可以判断两个变量相关的把握性越大
D.已知随机变量 ,且 ,则
【答案】C
【分析】根据比例分层抽样的性质可得样本容量,故可判断A的正误,根据两类数据之间的关系结合方差公式可
判断B的正误,根据 的意义可判断C的正误,根据正态分布的对称性可计算 的值,故可判断D的正
误.
【详解】对于A:设样本容量为 ,则 ,故 ,故A正确.
对于B:设样本数据 , ,…, 的均值为 ,
则数据 , ,.…, 的均值为 ,
故数据 , ,.…, 的方差为:
,
故B正确.
对于C: 越大,可以判断两个变量相关的把握性越大,越小则把握性越小,故C错误.
对于D:由正态分布的对称性可得:
,
故D正确.
故选:C.
二、多选题
27.(2023·湖南郴州·统考一模)下列说法正确的是( )
A.若随机变量 服从正态分布 ,且 ,则
B.一组数据 的第60百分位数为14C.若线性相关系数 越接近1,则两个变量的线性相关性越强
D.对具有线性相关关系的变量 ,其线性回归方程为 ,若样本点的中心为 ,则实数
的值是-4
【答案】ACD
【分析】根据正态分布概率性质计算判断A,由百分位数定义计算判断B,根据相关系数的概念判断C,把中心点
代入回归方程求解后判断D.
【详解】选项A,由已知 ,因此 ,A正确;
选项B,总共有10个数,由于 ,因此第60百分位数为 ,B错;
选项C,线性相关系数 越接近1,两个变量的线性相关性越强,越接近0,两个变量的线性相关性越弱,C正确;
选项D,由已知 ,解得 ,D正确.
故选:ACD.
28.(2023·福建龙岩·统考二模)下列说法正确的是( )
A.一组数1,5,6,7,10,13,15,16,18,20的第75百分位数为16
B.在经验回归方程 中,当解释变量 每增加1个单位时,相应变量 增加 个单位
C.数据 的方差为 ,则数据 的方差为
D.一个样本的方差 ,则这组样本数据的总和等于100
【答案】ACD
【分析】由百分位数的定义,即可判断A,由回归方程的性质即可判断B,由方差的性质即可判断CD.
【详解】因为 ,所以这组数据的第75百分位数是第8个数,即为16,A正确;
由回归方程可知,当解释变量 每增加1个单位时,相应变量 减少 个单位,B错误;
选项C,由 ,可得 ,C正确;
由 ,得 ,所以这组样本数据的总和等于 ,故D正确;
故选:ACD29.(2023·山西大同·统考模拟预测)已知 为随机事件,则下列表述中不正确的是( )
A. B.
C. D.
【答案】ABD
【分析】根据概率的性质及事件的运算关系,结合独立事件、条件概率公式判断各项的正误.
【详解】仅当 与 相互独立时, 成立,故A不正确;
当 和 是两个互斥事件时 才成立,故B不正确;
,故C正确;
,故D不正确.
故选:ABD
30.(2023·福建厦门·厦门双十中学校考模拟预测)设 是一个随机试验中的两个事件,且
,则( )
A. B.
C. D.
【答案】ACD
【分析】根据和事件的概率公式和条件概率公式逐个分析求解即可
【详解】对于A,因为 , ,
所以 ,所以A正确,
对于B,因为 ,所以 ,
所以 ,所以B错误,对于C,因为 ,所以 ,
所以 , ,
所以 ,所以C正确,
对于D,因为 ,所以 ,所以 ,
所以 ,所以D正确,
故选:ACD
31.(2023·海南省直辖县级单位·文昌中学校考模拟预测)交通事故是造成道路堵塞的主要原因之一.如图,这是某
市连续16日的各类交通事故发生次数统计图.若当日各类交通事故发生次数小于100表示道路通畅,当日各类交通
事故发生次数大于200表示道路严重拥堵,其余情况表示道路中度拥堵,则下列说法正确的是( )
A.这16日道路中度拥堵的频率为0.375
B.这16日交通事故发生次数的极差为192
C.这16日交通事故发生次数的中位数为202
D.这16日交通事故发生次数的平均值小于200
【答案】AD
【分析】根据样本数据的特征,结合折线图中的数据逐一分析每个选项即可.
【详解】这16日道路中度拥堵的频率为 ,故A项正确;
极差为 ,故B项错误;
根据中位数定义,中位数: ,故C项错误;,故D项正确.
故选:AD
三、填空题
32.(2023·全国·校联考模拟预测)已知样本数据 都为正数,其方差 ,
则样本数据 、 、 、 、 的平均数为 .
【答案】11
【分析】样本数据的平均数结合方差公式可得 ,于是 ,结合平均数的性质分析可得答案.
【详解】根据题意,设样本数据 、 、 、 、 的平均数为 ,
其方差
,
又 ,
则有 ,解得 ,
则样本数据 、 、 、 、 的平均数为 ;
故答案为:11.
33.(2023·全国·镇海中学校联考模拟预测)害虫防控对于提高农作物产量具有重要意义.已知某种害虫产卵数
(单位:个)与温度 (单位: )有关,测得一组数据 ,可用模型 进行拟合,利
用 变换得到的线性回归方程为 .若 ,则 的值为 .
【答案】
【分析】将非线性模型 两边同时取对数可得 ,再将样本中心点 代入回归方程可得 ,即可计算出 .
【详解】对 两边同时取对数可得 ;
即 ,可得
由 可得 ,
代入 可得 ,即 ,所以 .
故答案为:
34.(2023·上海徐汇·上海市南洋模范中学校考模拟预测)下列说法中正确的有 (填正确说法的序号).
①若样本数据 , ,…, 的方差为4,则数据 , ,…, 的标准差为4;
②已知随机变量 ,且 ,则 ;
③若线性相关系数 越接近1,则两个变量的线性相关性越弱;
④若事件A,B满足 , , ,则有 .
【答案】①②④
【分析】对于①,利用方差的性质求解判断,对于②,根据正态分布的性质计算,
对于③,根据相关系数的性质判断,对于④,利用独立事件和条件概率公式求解判断.
【详解】由于 ,所以数据 , ,…, 的方差为16,
故标准差为4,因此①正确;
根据正态分布, ,故 ,即 ,
故 .3,因此②正确;
线性相关系数 越接近1,则两个变量的线性相关性越强,故③错误;
由于 等价于“事件A与事件B相互独立,即 ,
故必有 ,因此④正确.
故答案为:①②④
35.(2023·江西九江·统考一模)2022年11月8日,江西省第十六届运动会在九江市体育中心公园主体育场开幕,
这是九江市举办的规模最大、规格最高的综合性体育赛事.赛事期间,有3000多名志愿者参加了活动.现将4名志愿者分配到跳高、跳远2个项目参加志愿服务活动,每名志愿者只分配到1个项目,每个项目至少分配1名志愿
者,则“恰好有一个项目分配了3名志愿者”的概率为 .
【答案】
【分析】按照分组分配的方法,再结合古典概型概率公式,即可求解.
【详解】4名志愿者分配到跳高、跳远2个项目,有 种方法,
将4名志愿者按照1,3的分组,再分配的方法,共有 种方法,
所以“恰好有一个项目分配了3名志愿者”的概率 .
故答案为:
36.(2023·四川绵阳·统考模拟预测)已知函数 ,若从集合 中随机选取一个元素
,则函数 恰有7个零点的概率是 .
【答案】
【分析】由 ,得 ,由 ,得 ,画出 的图象结合 ,且
,分情况求解即可.
【详解】由 ,得 ,当 时, 的最小值为 .
由 ,得 ,即 ,
因为 ,所以 .而 ,
当 时,方程 的实数解的个数分别为3,3,2;
当 时,方程 的实数解的个数分别为3,2,2;
当 时,方程 , 的实数解的个数均为2.
所以当 时,函数 恰有7个零点,故所求概率为 .
故答案为:【点睛】关键点点睛:此题考查函数与方程的综合应用,考查分段函数的性质的应用,解题的关键是画出函数图
象,结合图象求解即可,考查数形结合的思想,属于较难题.
四、解答题
37.(2023·河北沧州·校考三模)甲、乙、丙三人进行台球比赛,比赛规则如下:先由两人上场比赛,第三人旁观,
一局结束后,败者下场作为旁观者,原旁观者上场与胜者比赛,按此规则循环下去.若比赛中有人累计获胜3局,
则该人获得最终胜利,比赛结束,三人经过抽签决定由甲、乙先上场比赛,丙作为旁观者.根据以往经验,每局比
赛中,甲、乙比赛甲胜概率为 ,乙、丙比赛乙胜概率为 ,丙、甲比赛丙胜概率为 ,每局比赛相互独立且每
局比赛没有平局.
(1)比赛完3局时,求甲、乙、丙各旁观1局的概率;
(2)已知比赛进行5局后结束,求甲获得最终胜利的概率.
【答案】(1)
(2)
【分析】(1)根据独立事件的概率公式进行求解即可;
(2)分析比赛情况,根据和事件的概率公式进行求解即可.
【详解】(1)由题可知,甲、乙、丙各旁观1局的概率即为甲、乙、丙各胜1局的概率.
设甲、乙比赛甲胜,乙、丙比赛乙胜,丙、甲比赛丙胜分别为事件 , , ,则 , , 相互独立,
设比赛完3局时,甲、乙、丙各胜1局为事件 ,则 ,
则 ,
所以甲、乙、丙各旁观1局的概率为 .(2)设甲、乙、丙第 局比赛获胜分别为事件 , , , ,
设比赛完5局甲获得最终胜利为事件 ,则
,
,
,
,
,
,
所以 .
所以,已知比赛进行5局后结束,甲获得最终胜利的概率为 .
38.(2023·河北保定·统考二模)某学校为了提高学生的运动兴趣,增强学生身体素质,该校每年都要进行各年级
之间的球类大赛,其中乒乓球大赛在每年“五一”之后举行,乒乓球大赛的比赛规则如下:高中三个年级之间进
行单循环比赛,每个年级各派5名同学按顺序比赛(赛前已确定好每场的对阵同学),比赛时一个年级领先另一
个年级两场就算胜利(即每两个年级的比赛不一定打满5场),若两个年级之间打成 则第5场比赛定胜负.已
知高三每位队员战胜高二相应对手的可能性均为 ,高三每位队员战胜高一相应对手的可能性均为 ,高二每位
队员战胜高一相应对手的可能性均为 ,且队员、年级之间的胜负相互独立.
(1)求高二年级与高一年级比赛时,高二年级与高一年级在前两场打平的条件下,最终战胜高一年级的概率.
(2)若获胜年级积3分,被打败年级积0分,求高三年级获得积分的分布列和期望.
【答案】(1)
(2)分布列见解析,
【分析】(1)根据前两局平局的情况下,后面分两种情况计算高二年级最终战胜高一年级的概率即可;(2)由题可知高三年级获得积分的 的取值可为0,3,6,分别计算概率从而可得分布列与数学期望.
【详解】(1)设高二年级与高一年级在前两场打平的条件下,最终战胜高高一年级的事件为 ,
则
(2)根据题意得高三年级获得积分的 的取值可为0,3,6
的分布列为
0 3 6
39.(2023·吉林长春·东北师大附中校考一模)吉林省从2021年开始,高考取消文理分科,实行“ ”的模
式,其中的“1”表示每位学生必须从物理、历史中选择且只能选择一个科目.某校高一年级有2000名学生(其中
女生900人),该校为了解高一年级学生对物理、历史的选科情况,采用比例分配的分层抽样的方法抽取了200名
学生进行问卷调查,其中选择历史的男生有40人,选择物理的女生有30人.
(1)利用以上信息完成下面的 列联表,根据小概率值 的独立性检验,能否认为学生性别与选择科目有
关?
选择历
性别 选择物理 总计
史
男生
女生
总计
(2)某个外语学习小组共有7人,其中有3人选择了历史,4人选择了物理,随机抽取4人进行对话练习,用 表示抽中的4人中,选择历史的同学人数,求 的分布列及期望.
附: ,其中
0.100 0.050 0.025 0.010 0.005 0.001
2.706 3.841 5.024 6.635 7.879 10.828
【答案】(1)列联表见解析;能认为学生性别与选择科目有关
(2)分布列见解析;
【分析】(1)根据分层抽样得到抽取男生和女生的人数,进而得到列联表,求出 的值比较即可;
(2)根据排列组合的知识求出 各值时的概率即可,写出分布列,求出期望即可.
【详解】(1)根据采用比例分配的分层抽样得其中抽取男生的人数为 人,则抽取女生人数为
人,
则列联表如下:
选择历
性别 选择物理 总计
史
男生 70 40 110
女生 30 60 90
总计 100 100 200
则 ,
能认为学生性别与选择科目有关;
(2) 可能取值为 , , , ,
,
,
则 的分布列如:.
40.(2023·贵州遵义·统考模拟预测)某学校现有1000名学生,为调查该校学生一周使用手机上网时间的情况,
收集了 名学生某周使用手机上网时间的样本数据(单位:小时).将数据分为6组:
,并整理得到如下的频率分布直方图:
附: .
0.1 0.05 0.010 0.005 0.001
2.706 3.841 6.635 7.879 10.828
(1)估计该校学生一周平均使用手机上网时间(每组数据以该组中点值为代表);
(2)将一周使用手机上网时间在 内定义为“长时间使用手机上网”;一周使用手机上网时间在 内定义为
“不长时间使用手机上网”,在样本数据中,有 名学生不近视.请补充完成该周使用手机上网时间与近视程
度的列联表,若有 以上的把握认为“该校学生一周使用手机上网时间与近视程度有关”.那么本次调查的人
数至少有多少?
近
不近视 合计
视
长时间使用手机
不长时间使用手机
合计
【答案】(1) 小时
(2)列联表见解析,有 的把握认为“该校学生的每周使用手机上网时间与近视程度有关【分析】(1)利用平均数公式求解;
(2)根据列联表已有的数据和频率分布直方图求解;
【详解】(1)解:根据频率分布直方图得:
;
估计该校学生每周平均使用手机上网时间为 小时;
(2)根据题意填写 列联表如下,
近视 不近视 合计
长时间使用手机
不长时间使用手机
合计
由表中数据,计算 ,
所以有 的把握认为“该校学生的每周使用手机上网时间与近视程度有关”.
41.(2023·贵州毕节·校考模拟预测)为了解某一地区新能源电动汽车销售情况,一机构根据统计数据,用最小二
乘法得到电动汽车销量 (单位:万台)关于 (年份)的线性回归方程 ,且销量 的方差为
,年份 的方差为 .
(1)求 与 的相关系数 ,并据此判断电动汽车销量 与年份 的线性相关性的强弱.
(2)该机构还调查了该地区90位购车车主的性别与购车种类情况,得到的数据如下表:
购买电动汽
性别 购买非电动汽车 总计
车
男性 39 6 45
女性 30 15 45
总计 69 21 90
依据小概率值 的独立性检验,能否认为购买电动汽车与车主性别有关?
(3)在购买电动汽车的车主中按照性别进行分层抽样抽取7人,再从这7人中随机抽取3人,记这3人中男性的人数
为 ,求 的分布列和数学期望.
①参考数据: .②参考公式:线性回归方程为 ,其中 ;
相关系数 ,若 ,则可判断 与 线性相关较强;
,其中 .附表:
0.10 0.05 0.010 0.001
2.706 3.841 6.635 10.828
【答案】(1)电动汽车销量 与年份 的线性相关性的较强;
(2)依据小概率值 的独立性检验,认为购买电动汽车与车主性别有关;
(3)分布列见解析,数学期望为 .
【分析】(1)根据给定条件,利用线性回归方程,结合相关系数公式计算作答.
(2)根据给定的列联表求出 的观测值,再与临界值表比对作答.
(3)利用分层抽样求出男女性人数,再求出 的可能值及各个值对应的概率,列出分布列并求出方差作答.
【详解】(1)由 ,得 ,由 ,得 ,
因为线性回归方程 ,则 ,
即 ,
因此相关系数 ,
所以电动汽车销量 与年份 的线性相关性的较强.
(2)零假设 :购买电动汽车与车主性别无关,由表中数据得: ,
依据小概率值 的独立性检验,推断 不成立,
即认为购买电动汽车与车主性别有关,此推断犯错误的概率不大于0.05.
(3)按购买电动汽车的车主进行分层抽样,抽取的7人中男性有 人,女性有5人,
则 的可能值为 , ,
所以 的分布列为:
0 1 2
的数学期望 .
42.(2023·四川遂宁·射洪中学校考模拟预测)某骑行爱好者近段时间在专业人士指导下对骑行情况进行了统计,
各次骑行期间的身体综合指标评分x与对应用时y(单位:小时)如下表:
身体综合指标评分
1 2 3 4 5
用时( /小时) 9.5 8.6 7.8 7 6.1
(1)由上表数据看出,可用线性回归模型拟合 与 的关系,请用相关系数加以说明;
(2)建立 关于 的回归方程.
参考数据和参考公式:相关系数 , , ,
【答案】(1)答案见解析
(2)
【分析】(1)根据表格数据可分别计算出 与 的平均值,再代入计算可得相关系数近似为 ,即可知 与 相
关程度较高;
(2)根据(1)中的计算结果可得 ,代入计算可得 ,即可求得 关于 的回归方程.【详解】(1)由题意得 , ,
,
,
因此相关系数 .
即相关系数近似为 , 与 负相关,且相关程度相当高,从而可用线性回归模型拟合 与 的关系;
(2)由(1)中数据,得 , ,
所以 关于 的回归方程为 .
43.(2023·广东韶关·统考模拟预测)研究表明,如果温差本大,人们不注意保暖,可能会导致自身受到风寒刺激,
增加感冒患病概率,特别是对于几童以及年老体弱的人群,要多加防范某中学数学建模社团成员研究了昼夜温差
大小与某小学学生患感冒就诊人数多少之间的关系,他们记录了某六天的温差,并到校医室查阅了这六天中每天
学生新增感冒就诊的人数,得到数据如下:
日期 第一天 第二天 第三天 第四天 第五天 第六天
昼夜温差x( ) 4 7 8 9 14 12
新增感就诊人数y(位)
参考数据: ,
(1)已知第一天新增感冒就的学生中有4位男生,从第一天多增的感冒就诊的学生中随机取2位,其中男生人数记
为X,若抽取的2人中至少有一位女生的概率为 ,求随机变量X的分布列和数学期望;
(2)已知两个变量x与y之间的样本相关系数 ,请用最小二乘法求出y关于x的经验回归方程 ,据此
估计昼夜温差为15 时,该校新增感冒就诊的学生人数. 参考数据: ,【答案】(1) 的分布列见解析;
(2)15
【分析】(1)首先根据抽取的2人中至少有一位女生的概率计算出 ,从而得到随机变量X的取值,根据超几何
分布概率计算可得分布列和数学期望;
(2)首先根据样本相关系数 和已知条件计算出 ,进一步计算可得 ,利用最小二乘法计算出 请用
最小二乘法求出y关于x的经验回归方程 ,从而得到线性回归方程,将 代入可得答案.
【详解】(1)因为 ,所以 ,
所以 ,解得 ,即第一天新增患感冒而就诊的学生有9位,其中男生4位,女生5位,
则随机变量X的可能取值为 ,且 服从超几何分布,其中 ,
, , ,
的分布列为
0 1 2
数学期望为 ;
(2)因为 ,所以 ,所以 ,由于 ,
所以 ,所以 ,
因为 , ,
解得 ,所以 ,所以 ,
当 时, ,
据此估计昼夜温差为15 时,该校新增感冒就诊的学生人数为 .